如果你曾在早高峰通勤路上用手机应用学过西班牙语或法语,你很可能会感受到一种令人安心的熟悉感:像 familia 或 information 这样的词与英语如出一辙,句子结构大体遵循熟悉的语序,字母表更是你从小读到大的拉丁字母。
现在,想象一下翻开另一本教材:上面的文字从右向左书写,省略了绝大多数元音;或者仅仅因为你递给别人的是“一张纸”、“一根棍子”还是“一只小狗”,同一个表示“给”的动词就会幻化出十二种截然不同的形态。
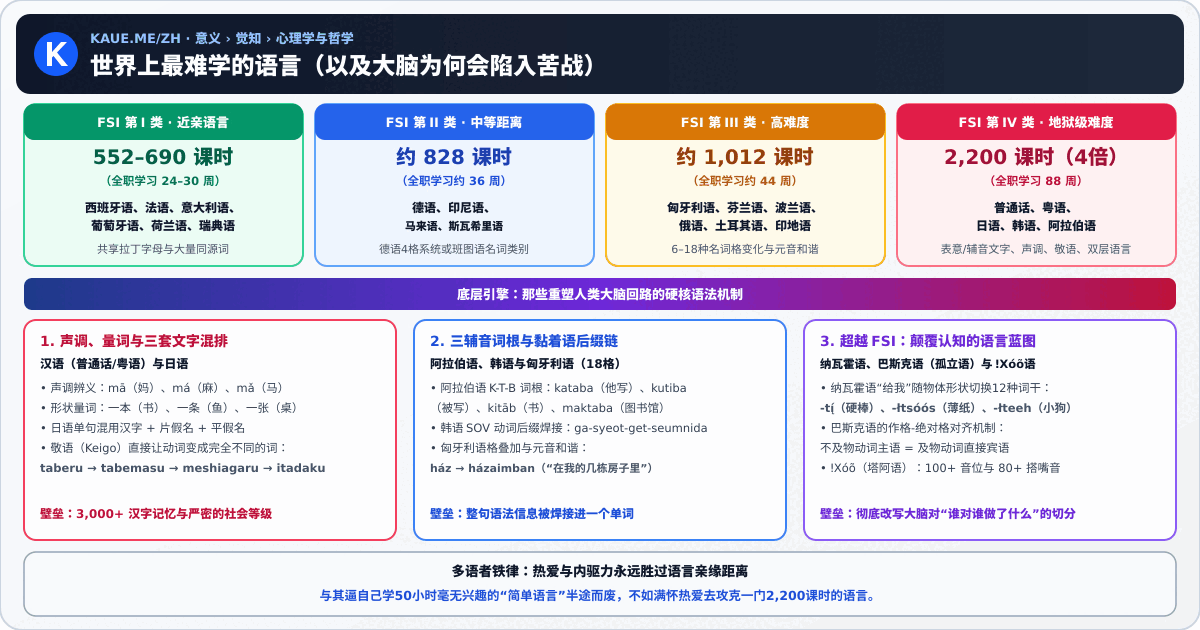
对于英语母语者而言,世界上最难学的五门主要语言是汉语普通话、粤语、阿拉伯语、日语和韩语。根据负责培训美国外交官的美国外交学院(FSI)的统计,这些“第 IV 类”(地狱级难度)语言需要大约 88 周(2,200 课时)的脱产强化学习,才能达到专业工作流利度。这几乎是西班牙语、意大利语或荷兰语等罗曼语族或日耳曼语族语言(仅需 552 至 690 课时)的四倍。
从纯粹的儿童发育视角来看,没有任何一门语言在客观上比另一门语言更难——东京、布达佩斯和开罗的学步幼儿掌握母语的速度几乎完全相同。然而对成年学习者来说,难度归结为语言距离(linguistic distance):目标语言在文字系统、语音体系、词汇、文化语境,尤其是语法上,与你的母语偏离得有多远(正如我们在**苏格拉底的“守护神(Daimon)”如何变成基督教的“恶魔(Demon)” 与从数学到网络迷因:“-Maxxing”出人意料的起源 **中所探讨的深层语言演变一样)。
下面让我们拆解世界上最难啃的语言,深入底层看看究竟是哪些独特的语法机制让大脑如此吃力。
FSI 最高难度梯队中的每一门语言,都给印欧语系学习者设下了截然不同的认知障碍。
乍看之下,汉语语法显得出奇地仁慈:没有动词变位,没有语法阴阳中性的词性划分,没有名词复数词尾,也没有欧洲语言意义上的时态。相反,汉语的真正壁垒在于声调音系、表意文字系统(汉字),以及对微妙的体标记助词和量词的高度依赖。
普通话有 4 个主要声调(外加轻声),而粤语根据分类标准有 6 到 9 个声调。声带音高的微小变化就会彻底改变一个音节的含义。此外,阅读一份日常报纸需要熟记 3,000 到 4,000 个独立汉字,而这些汉字几乎无法像拼音文字那样直接提示读音。
语法聚光灯:声调、量词与体标记
首先,音高在普通话中直接决定词义:
- mā(妈 – 第一声,高平调):母亲
- má(麻 – 第二声,升调):麻 / 发麻
- mǎ(馬 – 第三声,降升调):马
- mà(骂 – 第四声,全降调):责骂
其次,在汉语中不能把数词和名词直接连用(比如不能直接说“一书”或“三狗”)。每个名词都需要根据物体的物理形状或属性,在数字和名词之间嵌入特定的量词(分类词):
- yī běn shū(一本书):一 [装订成册之物的量词] 书
- yī tiáo yú(一条鱼):一 [细长柔韧之物的量词] 鱼
- yī zhāng zhuōzi(一张桌子):一 [平坦表面之物的量词] 桌子
最后,由于动词从不按时态变形,语境与 le(了) 或 guo(过) 等体助词承担了表达时间状态的任务:
- Wǒ chī fàn(我吃饭):我吃米饭 / 我正在吃饭。
- Wǒ chī le fàn(我吃了饭):我吃了饭。(助词“了”标记的是动作的完成体,而非单纯的过去时——它甚至可以用在将来语境中表示“等我吃了饭之后……”)
日语常被 FSI 称为“即便在第 IV 类语言中也最耗费时间”的语言,因为它要求在一个句子中同时混用三套截然不同的文字系统:
除了读写之外,日语句子遵循主语-宾语-谓语(SOV)语序,依赖后置助词,并强制执行一套极其严密的敬语体系(Keigo)——动词和词汇会根据社会等级关系发生翻天覆地的变化。
语法聚光灯:三套文字 + 社会等级(敬语)
看看这三套文字是如何在同一个简单句中同时出现的:“我在咖啡馆喝了咖啡。”
- 私はカフェでコーヒーを飲みました。 (Watashi wa kafe de kōhī o nomimashita.)
- 私(Watashi – “我”)和 飲(no- – “喝”的词干)用汉字书写。
- カフェ(kafe – “咖啡馆”)和 コーヒー(kōhī – “咖啡”)是外来词,用片假名书写。
- は(wa – 主题助词)、で(de – 场所助词“在”)、を(o – 直接宾语助词)以及 みました(mimashita – 礼貌体过去时词尾)则用平假名书写。
再看看像**“吃 / 喝”**(taberu / nomu)这样最基础的动词,会根据谈话对象的不同发生怎样的变形:
- 简体(对密友): Taberu(食べる)
- 礼貌体(日常标准): Tabemasu(食べます)
- 尊敬语(Sonkeigo – 抬高上司或客户的动作): Meshiagaru(召し上がる)
- 谦让语(Kenjōgo – 在尊长面前压低自己的动作): Itadaku(いただく)
动词不仅仅是加了一个礼貌后缀——而是直接变成了完全不同的另一个词!
阿拉伯语采用从右向左书写的辅音音素文字(abjad),字母会根据出现在词首、词中还是词尾而改变形状,而且日常书籍和报纸中会省略所有的短元音符号。你往往必须预先知道这个词是什么、在句子里充当什么语法成分,才能正确地把它朗读出来。
不过,阿拉伯语最大的实用门槛是双层语言现象(diglossia):现代标准阿拉伯语(MSA,用于新闻、文学和正式演讲)与各地日常口语方言(如埃及方言、黎凡特方言或摩洛哥方言)差异极大。学习者实际上等于要同时学习两门语言。
语法聚光灯:三辅音词根系统
印欧语系通常通过在固定词干前后添加前缀和后缀来构词(如 act → active → reactivation),而阿拉伯语则采用非串联构词法(non-concatenative morphology)。绝大多数词汇都围绕着一个承载核心概念的**“三辅音骨架(词根)”**构建。通过在骨架内部和周围穿插不同的元音模式与附加辅音,就能衍生出一整族词汇。
以承载**“书写”**核心概念的词根 K – T – B(ك - ت - ب) 为例:
- KaTaBa (kataba):他写了(过去时主动动词)
- KuTiBa (kutiba):被写了(过去时被动动词——仅靠改变内部元音就完成了被动转换!)
- KiTāB (kitāb):书
- KuTuB (kutub):书(复数)(不加复数词尾,而是通过改变内部元音形成的“破碎复数”)
- KāTiB (kātib):作家 / 作者
- maKTaB (maktab):书桌 / 办公室(前缀 ma- 表示动作发生的场所)
- maKTaBa (maktaba):图书馆 / 书店
颇具讽刺意味的是,韩语拥有语言学家公认全世界最简单、最符合逻辑的文字系统:谚文(Hangul)。这套由世宗大王于 1443 年主持创制的表音文字,只需一个下午就能学会。
真正的陷阱在你学会字母表之后立刻触发。与日语一样,韩语采用主语-宾语-谓语(SOV)语序,动词永远放在句子的最末尾——因此在说话人把话说完之前,你根本不知道他到底是在“买”、“讨厌”还是“吃”某样东西。此外,韩语是高度发达的黏着语,会把一长串后缀层层焊接在动词词干后面,用来表达时态、语气、使动以及七个不同的敬语等级。
语法聚光灯:黏着语动词后缀堆叠与敬语等级
在汉语或英语中,我们用独立的助词或助动词(“那位前辈大概已经去了吧”)来修饰动词;而在韩语中,这些概念会被直接焊接到动词词干 가-(ga-,“去”) 上:
- 가다 (ga-da):去(词典原形)
- 가시었다 → 가셨다 (ga-si-eot-da):去了(加入尊称标记 -si- + 过去时 -eot-)
- 가셨겠습니다 (ga-syeot-get-seumnida):“(那位受尊敬的人)大概已经去了。”
- 가- (ga-):词根(“去”)
- -시- (-si-):主语尊称后缀(抬高“去”的动作主体)
- -었- (-eot-):过去时后缀
- -겠- (-get-):推测 / 揣测后缀(“大概 / 想必”)
- -습니다 (-seumnida):对听话人表示正式礼貌的终结词尾
你甚至不需要离开拉丁字母圈,就能一头撞上语言的铜墙铁壁。第 III 类语言需要大约 **44 周(1,012 课时)**的强化学习,以其迷宫般的语法屈折变化而闻名。
从西班牙语、英语到俄语、希腊语,几乎所有欧洲语言都属于印欧语系。但匈牙利语、芬兰语和爱沙尼亚语不属于印欧语系。 它们属于乌拉尔语系(Uralic language family),与英语或拉丁语几乎没有任何同源词汇,并且运行在一套完全不同的语法蓝图之上:高度黏着、元音和谐,以及 14 到 18 种语法格(cases)。
乌拉尔语系不在名词前使用 in、on、to、from 或 with 这样的介词,而是把一连串后缀像串珠子一样粘在单词末尾。而且由于元音和谐律,每个后缀都有多个版本(前元音版 vs. 后元音版),以确保整个单词从头到尾的元音在听觉上保持和谐。
语法聚光灯:匈牙利语的格堆叠与元音和谐
看看匈牙利语名词 ház(房子)是如何把汉语或英语里的一个完整短语吸收进单个词里的:
- ház:房子
- házak:多栋房子(复数后缀 -ak)
- házaim:我的多栋房子(物主复数后缀 -aim)
- házaimban:在我的多栋房子里(内格后缀 -ban,意为“在……内部”)
- házaimból:从我的多栋房子里面出来(出格后缀 -ból,意为“从内部向外”)
因为 ház 包含后元音(á),所以它搭配后元音后缀 -ban(“在……里”)。如果换用包含前元音(e)的单词 kert(花园),元音和谐律就会强制后缀变为 -ben:kertemben(在我的花园里)。
俄语(6 个格)和波兰语(7 个格)等斯拉夫语言要求说话者时刻追踪句子里每一个词的精确语法功能。在汉语或英语中,语序决定了谁对谁做了什么(*“狗咬了人”与“人咬了狗”*意思完全相反)。
而在波兰语和俄语中,名词词尾决定了谁对谁做了什么。这意味着为了表达强调,句子的语序可以任意打乱,而每个名词、形容词、代词甚至数词都必须随之改变词尾。此外,斯拉夫语的动词成对出现,分为未完成体(Imperfective)与完成体(Perfective)——几乎每个动作你都得背两个不同的动词,取决于动作是正在持续进行还是只完成了一次。
语法聚光灯:在波兰语的 7 个格中变格“黑猫”
看看短语**“黑猫”**(czarny kot)在波兰语的 7 个语法格中是如何变形的:
- 主格(主语): Czarny kot śpi.(黑猫在睡觉。)
- 属格(所属 / 否定宾语): Nie widzę czarnego kota.(我没看见黑猫。)
- 与格(间接宾语): Daję mleko czarnemu kotu.(我给黑猫喂牛奶。)
- 宾格(直接宾语): Widzę czarnego kota.(我看见了黑猫。)
- 工具格(“用 / 与……一起”): Idę z czarnym kotem.(我和黑猫一起散步。)
- 前置格(地点 / 关于): Mówię o czarnym kocie.(我在谈论黑猫。)
- 呼格(直接称呼): O, czarny kocie!(啊,黑猫!)
请注意,在前置格和呼格中,甚至连词干末尾的辅音都从 -t 软化变异成了 -ci-(kot → kocie)!
由于地处北大西洋的地理隔绝状态,冰岛语自公元 9 世纪北欧定居者抵达以来几乎没有发生什么变化。现代冰岛人至今仍能相当轻松地阅读中世纪的《维京萨迦》。然而对学习者来说,这意味着必须掌握古老的古诺尔斯语(Old Norse)语法:四个格、三种词性、高度不规则的动词变位、连 1 到 4 的数字都要按性和格进行变格,以及拒绝国际外来词、坚持用古老词根合成新词的语言纯洁主义传统(例如“电脑”叫 tölva,由古语中的“数字”和“女先知”两个词熔合而成)。
FSI 仅对定期向外交官讲授的语言进行评级。在标准外交课程之外,世界上还有许多语言将人类语法推向了令印欧语系或汉语母语者都叹为观止的未知领域。
二战期间曾被美国海军陆战队用作牢不可破的军事密码的纳瓦霍语,是美国西南部原住民使用的一种多式综合语(polysynthetic)、高度以动词为核心的语言。仅仅一个纳瓦霍语动词就能浓缩相当于一整个英语句子的信息量,将主语代词、宾语代词、语气、体貌和方向前缀严丝合缝地编织在一起。
最令人称奇的是,纳瓦霍语使用分类动词词干(classificatory verb stems):语言中根本没有一个通用的“给”、“扔”或“拿”的动词。你必须根据所拿物体的物理形状、软硬质地以及是否有生命,从十几套完全不同的动词词干中做出选择。
语法聚光灯:纳瓦霍语的分类动词(“把它给我……”)
如果你想用纳瓦霍语说**“把它递给我”**,词尾的动词词干会根据物体的外观发生彻底改变:
- 细长、坚硬的物体(一支笔、一根棍子或一把步枪): Shaa nítį́(词干:-tį́)
- 扁平、柔韧的物体(一张纸、一条毯子或一张钞票): Shaa níłtsóós(词干:-łtsóós)
- 单个圆形或块状物体(一个球、一本书或一个苹果): Shaa ní*’ą́***(词干:-’ą́)
- 黏稠或无定形的物质(一团泥巴或湿面团): Shaa nítleeh(词干:-tleeh)
- 有生命的活物(一只小狗或一个婴儿): Shaa níłteeh(词干:-łteeh)
分布在西班牙北部与法国西南部交界处比利牛斯山脉的巴斯克语,是一门孤立语言(language isolate)——它是前印欧时代的活化石,与地球上已知的任何其他现存语言都没有亲缘关系。
除了完全独特的词汇体系外,巴斯克语还采用作格-绝对格(ergative-absolutive)语法对齐机制。在英语、汉语以及几乎所有欧洲语言中,无论动词后面有没有宾语,句子的主语总是受到完全相同的对待:
巴斯克语彻底改写了这一底层逻辑。在巴斯克语中,不及物动词的主语(“那个男人到了”)与及物动词的直接宾语(“男孩看见了那个男人”)使用完全相同的语法标记(绝对格);而真正发起及物动作的施事者,则必须加上一个特殊的作格后缀(-k)。
语法聚光灯:巴斯克语的作格-绝对格对齐
看看巴斯克语中 gizon(男人)和 mutil(男孩)这两个词会发生什么变化:
- 不及物句: Gizona etorri da.(“那个男人到了。”)
- 在这里,gizon-a 处于绝对格(词干 + 定冠词 -a“那个”)。
- 及物句: Mutilak gizona ikusi du.(“那个男孩看见了那个男人。”)
- 在这里,“那个男人”(gizon-a)变成了直接宾语,但它却保持着与他到达时完全相同的绝对格形式(gizona)!
- 与此同时,“那个男孩”(mutila)因为对别人施加了动作,必须加上作格后缀 -k:变成 mutilak。
主要分布在博茨瓦纳和纳米比亚的 ǃXóõ语,保持着全球所有语言中音位(phoneme)数量最多的世界纪录。英语只需大约 44 个不同的语音(音位)就够用了,而 ǃXóõ语却使用远超 100 个不同的辅音和元音,其中包括 80 多种不同的搭嘴音(click consonants,又称喌音),并与鼻音化、送气、喉塞音以及四个声调相互组合。甚至连它名字开头那个像感叹号一样的符号(ǃ),本身就代表着一个舌尖从上颚猛然向下弹击发出的齿龈搭嘴音。
| FSI 类别 | 全职脱产学习 | 课时数 | 代表性语言 | 英语母语者的主要瓶颈 |
|---|---|---|---|---|
| 第 I 类(近亲语言) | 24–30 周 | 552–690 课时 | 西班牙语、法语、意大利语、葡萄牙语、荷兰语、瑞典语 | 简单的动词变位与语法词性 |
| 第 II 类(中等距离) | 约 36 周 | 828 课时 | 德语、印尼语、马来语、斯瓦希里语 | 格变化系统(德语)或陌生的词根词汇(斯瓦希里语/印尼语) |
| 第 III 类(高难度) | 约 44 周 | 1,012 课时 | 俄语、波兰语、匈牙利语、芬兰语、土耳其语、印地语、越南语 | 繁复的名词格变化、黏着构词、声调或非拉丁字母文字 |
| 第 IV 类(地狱级难度) | 88 周 | 2,200 课时 | 普通话、粤语、日语、韩语、阿拉伯语 | 表意/辅音文字系统、声调音系、双层语言现象与敬语体系 |
当你看到 2,200 个课时的学习量或 18 种语法格时,难免会感到望而生畏。然而,资深多语者(polyglots)和语言学家都公认一个至关重要的秘密:热爱与每日的坚持,永远胜过语言亲缘上的接近(尤其是当你结合**别让情绪对你的日程表行使否决权 **中的“建筑师 vs. 施工者”习惯引擎时)。
一个由衷热爱日本电影、韩国音乐或阿拉伯历史的学习者,会心甘情愿地投入 2,000 小时的练习并最终流利掌握它;相反,一个强迫自己去学某门毫无兴趣的“第 I 类简单语言”的人,往往撑不过 50 小时就会放弃。每一个看似“不可能学会”的语法特征——无论是汉语的声调、匈牙利语的后缀链,还是巴斯克语的作格——都只是人类心智为了整理现实世界而发明的另一种精妙方式。
当我发布关于美好生活的新随笔、读书笔记和实践指南时接收通知。绝无垃圾邮件——可随时退订。
有任何问题、见解或建议吗?欢迎在下方分享您的想法。评论功能由 GitHub Discussions 驱动(无广告、无垃圾信息)——点击下方的使用 GitHub 登录即可发表评论或互动(注册免费 GitHub 账号不到一分钟即可完成)。
最后更新于 2026年11月13日.
免责声明:本站所有内容仅供信息参考与教育用途,不构成任何医疗、心理、财务、投资、税务或法律建议。此处呈现的观点、整理与见解仅代表我个人,不代表我雇主的立场。书籍、演讲及文章摘要均为独立的教育性评论,其知识产权归原作者所有。本站可能使用 AI 工具辅助编辑、排版与归纳;尽管我们竭力确保准确无误,但仍可能存在疏漏。隐私政策:本站使用第三方服务提供可选的邮件通讯订阅(Mailchimp)、评论(giscus / GitHub Discussions)以及嵌入媒体(YouTube),这些服务可能会依据各自的隐私政策处理访客的 IP 地址和 Cookie。