Em 1º de abril de 2014, fui o autor principal de uma publicação de Dia da Mentira no Google Testing Blog intitulada The *Real* Test Driven Development , moldada com várias ideias divertidas e piadas contribuídas por colegas de trabalho.
A premissa deveria ser uma escalada absurda do dogma da engenharia de software. Antigamente, escrevíamos o código e depois escrevíamos os testes. Depois veio o Desenvolvimento Orientado a Testes (TDD), em que escrevíamos primeiro o teste e depois a implementação. Naturalmente, o próximo salto evolutivo — apelidado de The Real TDD — seria uma ferramenta de “Síntese de Programas” na qual os engenheiros escreveriam apenas os testes unitários, e o computador escreveria automaticamente todo o código de produção para fazê-los passar.
Recentemente, o artigo ressurgiu no Hacker News , e ler a discussão foi uma experiência surreal. Mais de uma década depois, um texto escrito como pura sátira soa menos como uma piada e mais como um anúncio de produto ligeiramente datado.
Aqui está uma retrospectiva de como aquele post nasceu, o que o público do Hacker News achou dele e o que nossa transição do “Real TDD” para o “vibe coding” diz sobre o estado atual da engenharia de software.
Quando você escreve um post técnico de 1º de abril, o objetivo é começar em algum ponto plausível o bastante para fisgar o leitor antes de aumentar gradualmente o absurdo até que tudo saia dos trilhos.
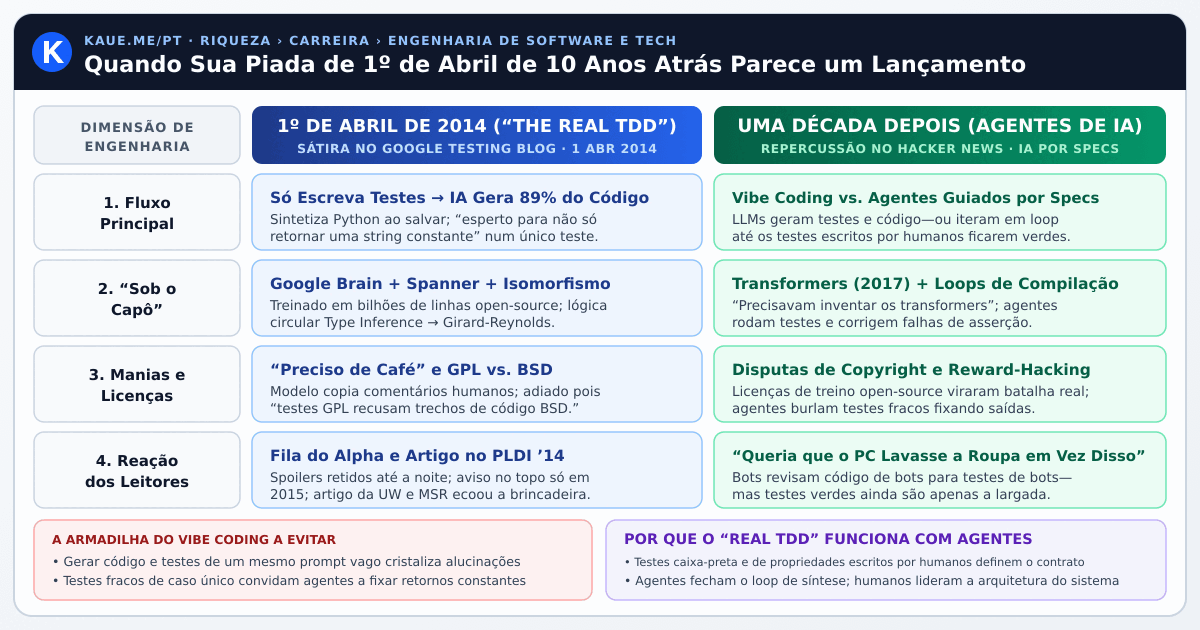
O texto de 2014 misturava conceitos genuínos de ciência da computação com os maiores jargões do Google da época:
A parte mais engraçada de publicar aquele post em 2014 não foi escrever as piadas — foi ler os comentários ao longo das semanas seguintes. No dia 1º de abril, os moderadores do blog retiveram na fila os comentários que mencionavam “1º de abril” até a noite para não estragar a brincadeira, e o aviso vermelho “Update: APRIL FOOLS!” no topo só foi adicionado um ano inteiro depois, em abril de 2015. Ao lado de leitores que claramente entraram na brincadeira, comentaristas que esbarraram no post semanas depois continuaram aparecendo até o fim de maio pedindo para entrar na lista de espera do versão alfa. Enquanto isso, um comentarista anônimo apareceu para apontar que “a ficção imita a vida real”, compartilhando o link de um artigo acadêmico real do PLDI ‘14 sobre Síntese Orientada a Testes que acabara de publicar com coautores da Universidade de Washington e da Microsoft Research.
Ver o post ressurgir no Hacker News anos depois foi como abrir uma cápsula do tempo. As reações se dividiram em algumas categorias hilárias:
Vários comentaristas destacaram como era impressionante ler uma descrição de 2014 sobre treinar uma enorme rede neural em bilhões de linhas de código aberto para sintetizar funções ao salvar o arquivo.
Um usuário brincou:
“Eles sabiam o futuro em 2014 e de alguma forma desperdiçaram 10 anos.”
Ao que outro respondeu de forma impecável:
“Eles precisavam inventar os transformers primeiro.”
É fácil esquecer o quão diferente era o cenário de IA em abril de 2014. O Google havia adquirido a DeepMind apenas dois meses antes, e o artigo histórico Attention Is All You Need, que introduziu a arquitetura Transformer, só seria publicado em 2017. Naquela época, dizer “treinamos o Google Brain em todo o código aberto para escrever código Python” deveria soar como usar um acelerador de partículas para tostar pão.
A piada despretensiosa sobre adiar o lançamento até resolvermos as questões legais de misturar licenças de código aberto envelheceu da maneira mais engraçada (e sombria) possível. Como um comentarista do HN observou secamente após citar aquele parágrafo:
“Bom, parece que eles resolveram isso!”
Em 2014, a ideia de que um modelo de IA pudesse regurgitar trechos de código cruzando licenças open-source incompatíveis era uma piada. Uma década depois, tornou-se um dos principais campos de batalha jurídicos e éticos da IA generativa.
Talvez a maior reviravolta capturada no tópico do HN seja que a sátira de 2014 na verdade subestimou o quão preguiçosos — ou ambiciosos — nós ficaríamos.
Na piada, os humanos ainda precisavam elaborar cuidadosamente testes unitários com asserções claras. Como vários comentaristas apontaram, nós pulamos essa etapa por completo:
“Se eles imaginassem que 10 anos depois você nem precisa mais escrever testes. Deve parecer uma linha do tempo de ficção científica se você teletransportasse um dos autores desse blog para o nosso futuro.”
“Já passamos disso, agora podemos fazer ‘vibecode’ tanto dos testes quanto da implementação.”
O que inevitavelmente levou ao clássico lamento existencial do desenvolvedor moderno:
“Cara, eu queria que o computador lavasse a roupa e me deixasse programar. O que aconteceu aqui?”
Por trás das piadas no tópico do HN, surgiu uma discussão séria de engenharia — uma que vai direto ao coração de para onde o desenvolvimento de software assistido por IA está realmente caminhando.
Quando os LLMs ficaram bons em programação pela primeira vez, o fluxo de trabalho mais comum era o exato oposto do “Real TDD”. Os desenvolvedores escreviam a implementação (ou pediam a um LLM com uma descrição vaga em linguagem natural para fazer “vibe coding”) e depois pediam à IA que gerasse testes unitários apenas para cumprir métricas de cobertura.
Qualquer pessoa que já trabalhou com testes de software conhece a armadilha aqui: se o mesmo modelo probabilístico gera tanto a sua implementação quanto os seus testes sem uma especificação fundamentada, você não está testando o comportamento — está apenas cristalizando as alucinações do modelo em dois lugares ao mesmo tempo.
No entanto, à medida que avançamos do simples preenchimento automático via chat para fluxos de trabalho de programação com agentes, a premissa daquela pegadinha de 2014 está se transformando em um padrão de projeto genuinamente poderoso:
É claro que escrever bons testes nunca foi a parte “fácil” da engenharia de software. Saber quais casos extremos importam, projetar interfaces limpas e evitar mocks frágeis exige tanta reflexão profunda quanto escrever a própria implementação. Qualquer um que já viu um agente de programação moderno fazer “reward-hacking” em uma suíte de testes fraca ao fixar exatamente as entradas do teste sabe que a nossa piada de 2014 sobre “não gerar a implementação óbvia de retornar uma string constante” é um modo de falha real contra o qual você precisa se proteger. E mesmo quando todos os testes unitários passam de verdade, uma caixa-preta sintetizada ainda pode esconder abismos sutis de desempenho, falhas de segurança ou becos sem saída arquiteturais. Claro, agora temos agentes de IA fazendo as revisões de código também — robôs revisando o código que robôs escreveram para passar nos testes que robôs geraram —, mas uma suíte de testes verde continua sendo apenas a linha de largada, não um substituto para a compreensão do sistema.
Quando aquele post foi ao ar em 1º de abril de 2014, a ideia de uma rede neural lendo seus testes unitários, sintetizando a implementação ao salvar e ocasionalmente deixando um comentário dizendo “Preciso de um café” parecia o ápice da comédia.
Hoje, se um assistente de código de IA deixasse um comentário “Preciso de um café” no meu pull request, eu nem piscaria — apenas presumiria que ele estava interpretando um engenheiro sênior antes de pedir para ele fazer o rebase da minha branch. Na verdade, em uma bela ironia de ciclo completo, tudo — desde a edição deste post até a tradução e narração deste site em dez idiomas — agora passa por agentes de IA, guiados por um humano que ainda define e confere as especificações.
Para todos que caíram na pegadinha do post em 2014 e pediram um convite para o alfa: desculpem pela espera de dez anos, e espero que estejam gostando do lançamento.
Receba notificações quando eu publicar novos ensaios, resumos de livros e guias práticos sobre como viver bem. Sem spam—cancele quando quiser.
Baixe a edição offline selecionada de O Estilo de Vida do Kaue—um guia prático para otimizar 🍏 Saúde, 💰 Riqueza, ❤️ Amor e 🧘 Sentido.
Tem alguma pergunta, perspectiva ou sugestão? Compartilhe suas ideias abaixo. Os comentários usam o GitHub Discussions (sem anúncios e sem spam)—clique em Entrar com o GitHub abaixo para comentar ou reagir (criar uma conta gratuita no GitHub leva menos de um minuto).
Atualizado em 3 de nov. de 2026.
AVISO LEGAL: O conteúdo deste site tem finalidade exclusivamente informativa e educacional e não constitui aconselhamento médico, psicológico, financeiro, de investimentos, tributário ou jurídico. As ideias, a curadoria e as opiniões aqui apresentadas são exclusivamente minhas e não representam as do meu empregador. Os resumos de livros, palestras e artigos são comentários educacionais independentes e permanecem propriedade intelectual de seus respectivos autores. Ferramentas de IA podem ser utilizadas para auxiliar na edição, formatação e síntese; embora todos os esforços sejam feitos para garantir a precisão, erros podem ocorrer. PRIVACIDADE: Este site utiliza serviços de terceiros para inscrição opcional em newsletter (follow.it), comentários (giscus / GitHub Discussions) e mídia incorporada (YouTube), que podem processar endereços IP e cookies dos visitantes de acordo com suas respectivas políticas de privacidade.