아침 출근길에 앱으로 스페인어나 프랑스어를 배워본 적이 있다면, 아마도 꽤 친숙하고 안심이 되는 영역을 발견했을 것입니다. familia나 information 같은 단어들은 영어와 무척 닮아 있고, 문장 어순도 익숙하며, 알파벳 역시 어릴 때부터 읽어온 로마자 그대로입니다.
이제 글자가 오른쪽에서 왼쪽으로 흘러가며 모음 대부분을 생략하는 교재를 펼친다고 상상해 보십시오. 혹은 상대방에게 건네는 물건이 종이 한 장인지, 막대기 하나인지, 강아지 한 마리인지에 따라 단 하나의 동사가 열두 가지의 완전히 다른 형태로 돌변하는 언어를 상상해 보십시오.
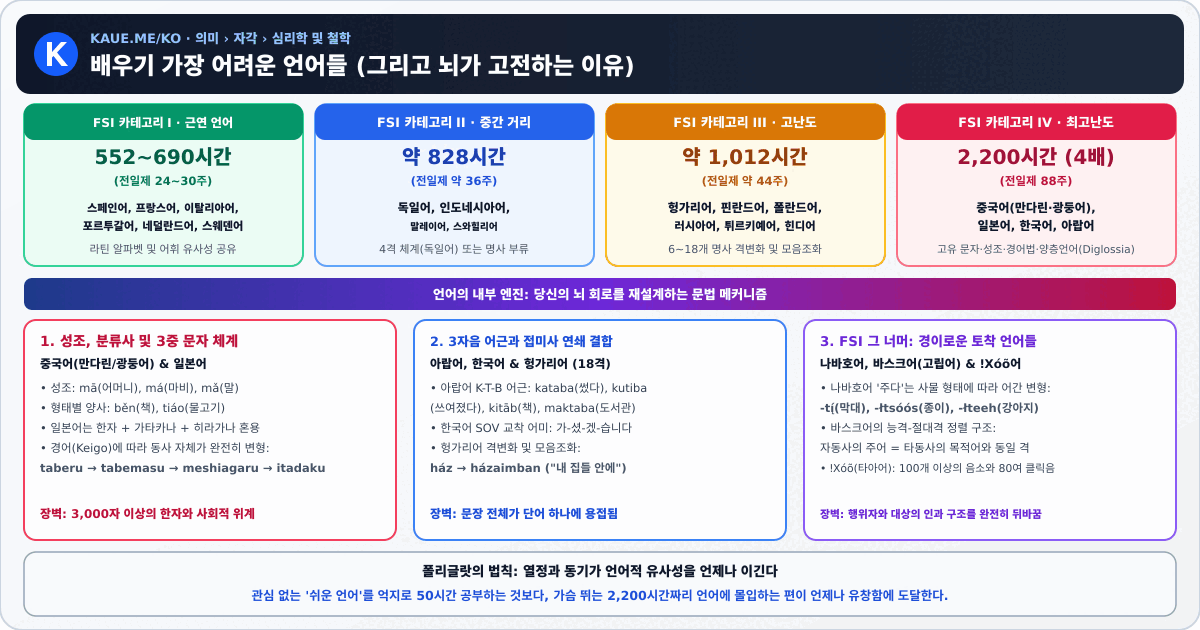
영어 원어민에게 가장 배우기 어려운 5대 주요 언어는 중국어(만다린), 광둥어, 아랍어, 일본어, 그리고 한국어입니다. 미국 외교관 교육을 담당하는 국무부 산하 외교연구원(FSI)에 따르면, 이 ‘카테고리 IV’(최고난도) 언어들은 업무상 유창한 수준에 도달하기까지 약 **88주(2,200수업시간)**의 집중 학습이 필요합니다. 이는 552~690시간이 걸리는 스페인어, 이탈리아어, 네덜란드어 같은 로망스어나 게르만어보다 거의 4배나 더 긴 시간입니다.
순수한 발달심리학적 관점에서 보면 객관적으로 더 어려운 언어란 존재하지 않습니다. 도쿄, 부다페스트, 카이로의 아기들은 모두 거의 같은 속도로 모국어를 마스터합니다. 하지만 성인 학습자에게 난이도는 언어적 거리(linguistic distance)로 귀결됩니다. 목표 언어가 문자 체계, 발음 체계, 어휘, 문화적 맥락, 그리고 무엇보다도 문법에서 모국어와 얼마나 극적으로 동떨어져 있는지가 핵심입니다(소크라테스의 ‘다이몬’은 어떻게 기독교의 ‘악마(데몬)‘가 되었는가 및 **수학에서 밈으로: ‘-Maxxing(맥싱)‘의 놀라운 기원 **에서 살펴본 언어 구조의 진화와도 맥을 같이합니다).
세계에서 가장 까다로운 언어들을 하나씩 해부해 보고, 우리 뇌를 고전하게 만드는 구체적인 문법 메커니즘을 들여다봅시다.
FSI 최상위 등급에 속하는 언어들은 각각 고유한 인지적 장벽을 가지고 있습니다.
언뜻 보기에 중국어 문법은 놀라울 정도로 자비로워 보입니다. 동사 활용도 없고, 문법적 성(gender)도 없으며, 명사의 복수형 어미 변화나 유럽 언어식의 시제도 없습니다. 대신 그 어려움은 성조 음운론, 표의문자 체계(한자), 그리고 미묘한 상(aspect) 조사와 **양사(분류사)**의 사용에 숨어 있습니다.
만다린(표준 중국어)은 4개의 주요 성조(와 경성)를 사용하며, 광둥어는 분류에 따라 6개에서 9개의 성조를 사용합니다. 목소리 높낮이가 살짝만 바뀌어도 음절의 뜻이 완전히 달라집니다. 게다가 신문을 읽으려면 발음에 대한 단서를 거의 주지 않는 3,000~4,000개의 서로 다른 한자(Hanzi)를 외워야 합니다.
문법 스포트라이트: 성조, 양사, 그리고 상(Aspect)
첫째, 만다린에서는 음높이(성조)가 어휘의 의미를 통째로 바꿉니다.
- mā (妈 – 높고 평평한 제1성): 어머니
- má (麻 – 올라가는 제2성): 삼(대마) / 마비되다
- mǎ (馬 – 내려갔다 올라가는 제3성): 말(馬)
- mà (骂 – 급격히 내려가는 제4성): 꾸짖다 / 욕하다
둘째, 중국어에서는 명사를 그냥 바로 셀 수 없습니다(예: “책 한"이나 “개 셋”). 대상의 물리적 형태나 성질에 따라 숫자와 명사 사이에 특정한 **양사(분류사)**를 반드시 넣어야 합니다.
- yī běn shū (一本书): 한 [제본된 책자를 세는 양사] 책
- yī tiáo yú (一条鱼): 한 [길고 유연한 물체를 세는 양사] 물고기
- yī zhāng zhuōzi (一张桌子): 한 [평평한 표면을 세는 양사] 탁자
마지막으로, 동사가 시제에 따라 변하지 않기 때문에 문맥과 le(了) 또는 guo(过) 같은 상 조사가 시간의 무게를 담당합니다.
- Wǒ chī fàn (我吃饭): 나는 밥을 먹는다 / 먹고 있다. (직역: “나 먹다 밥.”)
- Wǒ chī le fàn (我吃了饭): 나는 밥을 먹었다. (조사 le는 과거 시제 자체가 아니라 ‘동작의 완료’를 나타내므로, 미래 문맥에서 “내가 밥을 다 먹고 나면…“이라는 뜻으로도 쓰입니다.)
FSI에서도 카테고리 IV 중 가장 시간이 많이 걸리는 언어로 꼽히는 일본어는, 단 한 문장 안에서 세 가지의 서로 다른 문자 체계를 동시에 다루어야 합니다.
읽기뿐만 아니라 일본어 문장은 주어-목적어-동사(SOV) 어순으로 진행되며, 후치사(조사)에 의존하고, 사회적 위계에 따라 동사와 어휘가 극적으로 바뀌는 정교한 **경어 체계(Keigo)**를 강제합니다.
문법 스포트라이트: 세 가지 문자 + 사회적 위계(경어)
**“나는 카페에서 커피를 마셨습니다”**라는 간단한 한 문장에 세 가지 문자 체계가 어떻게 동시에 등장하는지 보십시오.
- 私はカフェでコーヒーを飲みました。 (Watashi wa kafe de kōhī o nomimashita.)
- 私(Watashi – “나”)와 飲(no- – “마시다"의 어간)은 한자로 표기됩니다.
- カフェ(kafe – “카페”)와 コーヒー(kōhī – “커피”)는 외래어로 가타카나로 표기됩니다.
- は(wa – 주제 보조사), で(de – 장소 격조사 “에서”), を(o – 목적격 조사), 그리고 みました(mimashita – 정중한 과거형 동사 어미)는 히라가나로 표기됩니다.
이제 누구와 대화하느냐에 따라 “먹다 / 마시다”(taberu / nomu) 같은 기본 동사가 어떻게 변하는지 보십시오.
- 반말 (친한 친구에게): Taberu (食べる)
- 정중어 (일상 표준): Tabemasu (食べます)
- 존경어 (Sonkeigo – 상사나 고객의 행동을 높임): Meshiagaru (召し上がる)
- 겸양어 (Kenjōgo – 윗사람 앞에서 자신의 행동을 낮춤): Itadaku (いただく)
동사에 단순히 정중한 어미만 붙는 것이 아니라, 아예 완전히 다른 단어로 변신해 버립니다!
아랍어는 오른쪽에서 왼쪽으로 쓰는 아브자드(abjad, 자음문자) 체계를 사용합니다. 글자가 단어의 처음, 중간, 끝 중 어디에 위치하느냐에 따라 모양이 바뀌며, 일상적인 책이나 신문에서는 짧은 모음 기호가 생략됩니다. 소리 내어 읽으려면 그 단어와 문장 내 문법적 역할을 미리 알고 있어야 하는 경우가 허다합니다.
하지만 가장 큰 실용적 장벽은 양층언어(diglossia) 현상입니다. 뉴스, 문학, 공식 연설에 쓰이는 현대 표준 아랍어(MSA)와 일상에서 실제로 쓰이는 지역 방언(이집트, 레반트, 모로코 아랍어 등)이 극적으로 다릅니다. 학습자는 사실상 한 언어의 두 가지 버전을 동시에 공부해야 합니다.
문법 스포트라이트: 3자음 어근 체계
고정된 어간에 접두사와 접미사를 붙여 단어를 만드는 인도유럽어족(예: act → active → reactivation)과 달리, 아랍어는 **비연결적 형태론(non-concatenative morphology)**을 사용합니다. 대부분의 단어는 핵심 개념을 담은 **세 개의 자음 뼈대(어근)**를 중심으로 만들어집니다. 그 뼈대 안쪽과 주변에 다양한 모음 패턴과 자음을 교차해 직조함으로써 단어 가족 전체를 생성합니다.
**“쓰기(writing)”**라는 핵심 개념을 가진 어근 **K – T – B (ك - ت - ب)**를 예로 들어 보겠습니다.
- KaTaBa (kataba): 그가 썼다 (과거 능동 동사)
- KuTiBa (kutiba): 그것이 쓰여졌다 (과거 수동 동사—오직 내부 모음 변화만으로 수동태가 됨!)
- KiTāB (kitāb): 책
- KuTuB (kutub): 책들 (어미 -s를 붙이는 대신 내부 모음을 변형시켜 만드는 ‘불규칙 복수’)
- KāTiB (kātib): 작가 / 저자
- maKTaB (maktab): 책상 / 사무실 (접두사 *ma-*는 행위의 장소를 나타냄)
- maKTaBa (maktaba): 도서관 / 서점
아이러니하게도 한국어는 언어학자들이 세계에서 가장 쉽고 논리적인 문자 체계로 꼽는 **한글(Hangul)**을 자랑합니다. 1443년 세종대왕이 창제한 이 표음문자는 단 한나절이면 배울 수 있습니다.
함정은 글자를 배운 직후에 작동합니다. 일본어와 마찬가지로 한국어는 주어-목적어-동사(SOV) 통사 구조를 사용하므로 동사가 항상 문장 맨 끝에 옵니다. 따라서 화자가 말을 끝내기 전까지는 누군가가 무언가를 사는지, 미워하는지, 먹는지 알 수 없습니다. 게다가 한국어는 고도의 교착어여서, 시제, 서법, 사동, 그리고 7단계의 상대높임법을 표현하기 위해 동사 어간 뒤에 접미사 사슬을 겹겹이 이어 붙입니다.
문법 스포트라이트: 교착어 동사 어미 결합과 높임법
영어에서는 조동사들(“might have wanted to go”)을 따로 띄어 써서 동사를 수식하지만, 한국어에서는 이러한 개념들이 동사 어간 **가-(ga-, “to go”)**에 직접 용접됩니다.
- 가다 (ga-da): 가다 (사전형)
- 가시었다 → 가셨다 (ga-si-eot-da): 가셨다 (존경의 선어말어미 -시- + 과거 시제 -었-)
- 가셨겠습니다 (ga-syeot-get-seumnida): "(존경하는 분이) 아마 가셨을 것입니다.”
- 가- (ga-): 어근 (“가다”)
- -시- (-si-): 주체 높임 선어말어미 (가는 주체를 높임)
- -었- (-eot-): 과거 시제 선어말어미
- -겠- (-get-): 추측 / 추정 선어말어미 (“아마 ~했을 것이다”)
- -습니다 (-seumnida): 청자를 높이는 하십시오체 종결어미
언어의 장벽에 부딪히기 위해 굳이 라틴 알파벳 문화권을 벗어날 필요도 없습니다. 카테고리 III 언어들은 약 **44주(1,012수업시간)**의 집중 학습을 요구하며, 미로처럼 복잡한 문법적 굴절과 격변화로 악명이 높습니다.
스페인어와 영어부터 러시아어와 그리스어에 이르기까지 거의 모든 유럽 언어는 인도유럽어족에 속합니다. 하지만 헝가리어, 핀란드어, 에스토니아어는 그렇지 않습니다. 이들은 **우랄어족(Uralic language family)**에 속하며, 영어와 공유하는 어근 어휘가 사실상 제로에 가깝고 완전히 다른 문법 설계도로 작동합니다. 바로 강력한 교착성, 모음조화, 그리고 **14개에서 18개에 달하는 문법적 격(cases)**입니다.
명사 앞에 in, on, to, from, with 같은 전치사를 두는 대신, 우랄어족 언어들은 단어 끝에 폭포수처럼 이어지는 접미사를 붙입니다. 게다가 모음조화 때문에 단어 전체의 모음이 음향적으로 어울리도록 모든 접미사가 여러 버전(전설모음용 vs. 후설모음용)으로 존재합니다.
문법 스포트라이트: 헝가리어의 격 중첩과 모음조화
헝가리어 명사 ház(집)가 영어라면 구(phrase) 전체가 될 의미를 어떻게 단어 하나에 흡수하는지 보십시오.
- ház: 집
- házak: 집들 (복수 접미사 -ak)
- házaim: 내 집들 (소유 복수 접미사 -aim)
- házaimban: 내 집들 안에 ("~안에"를 뜻하는 내격 접미사 -ban)
- házaimból: 내 집들 안에서 밖으로 ("~안에서 밖으로"를 뜻하는 출격 접미사 -ból)
ház에는 후설모음(á)이 들어 있기 때문에 후설모음용 접미사 -ban(“안에”)을 취합니다. 만약 전설모음(e)이 들어 있는 kert(정원)라는 단어를 쓰면, 모음조화 법칙에 따라 접미사가 -ben으로 변이하여 kertemben(내 정원 안에)이 됩니다.
러시아어(6격)와 폴란드어(7격) 같은 슬라브어들은 문장 속 모든 단어의 정확한 문법적 기능을 추적하도록 요구합니다. 영어에서는 어순이 누가 무엇을 했는지 알려줍니다(*“The dog bit the man”*은 *“The man bit the dog”*와 정반대 뜻입니다).
반면 폴란드어와 러시아어에서는 명사 어미가 누가 무엇을 했는지 알려주므로, 강조를 위해 어순을 마음대로 뒤섞을 수 있는 대신 모든 명사, 형용사, 대명사, 심지어 숫자까지 어미가 바뀝니다. 또한 슬라브어 동사는 상(aspect)의 쌍(불완료상 vs. 완료상)으로 이루어져 있어, 동작이 진행·반복되는지 아니면 단 한 번 완료되는지에 따라 거의 모든 동작마다 두 개의 별도 동사를 외워야 합니다.
문법 스포트라이트: 폴란드어의 7가지 격으로 “검은 고양이” 변화시키기
“검은 고양이”(czarny kot)라는 구절이 폴란드어의 7개 격에 따라 어떻게 변하는지 보십시오.
- 주격 (주어): Czarny kot śpi. (검은 고양이가 잔다.)
- 생격 (소유 / 부정): Nie widzę czarnego kota. (나는 검은 고양이를 보지 못한다.)
- 여격 (간접목적어): Daję mleko czarnemu kotu. (나는 검은 고양이에게 우유를 준다.)
- 대격 (직접목적어): Widzę czarnego kota. (나는 검은 고양이를 본다.)
- 조격 ("~와 함께 / 수단”): Idę z czarnym kotem. (나는 검은 고양이와 함께 걷는다.)
- 전치격 (장소 / 주제): Mówię o czarnym kocie. (나는 검은 고양이에 대해 말한다.)
- 호격 (부름): O, czarny kocie! (오, 검은 고양이여!)
전치격과 호격에서는 어간의 마지막 자음마저 -t에서 **-ci-**로 변이(kot → kocie)한다는 점에 주목하십시오!
북대서양의 지리적 고립 덕분에 아이슬란드어는 9세기에 노르드 정착민들이 도착한 이래 놀라울 정도로 거의 변하지 않았습니다. 현대 아이슬란드인들은 여전히 중세 바이킹 사가(Saga)를 비교적 쉽게 읽을 수 있습니다. 그러나 학습자에게 이는 고풍스러운 고대 노르드어 문법을 그대로 익혀야 함을 뜻합니다. 4개의 격, 3개의 성, 극도로 불규칙한 동사 활용, 성과 격에 따라 변화하는 숫자 1~4, 그리고 외래어를 거부하고 고대 어근을 합쳐 신조어를 만드는 언어 순화 정책(예: ‘컴퓨터’를 뜻하는 tölva는 ‘숫자’와 ‘여예언자’를 합친 말입니다)을 마주하게 됩니다.
FSI는 외교관들에게 정기적으로 교육하는 언어만 분류합니다. 표준 외교 커리큘럼 밖으로 눈을 돌리면, 인도유럽어 화자들에게는 완전히 외계어처럼 느껴질 만큼 인간 문법의 영역을 확장한 언어들이 존재합니다.
제2차 세계대전 당시 미 해병대가 절대 해독할 수 없는 암호로 사용했던 것으로 유명한 나바호어는 미국 남서부에서 쓰이는 다합성적(polysynthetic) 동사 중심 언어입니다. 나바호어 동사 하나에는 주어 대명사, 목적어 대명사, 서법, 상, 방향 접두사가 촘촘한 형태론적 퍼즐처럼 엮여 들어가 영어 한 문장 전체만큼의 정보를 담아낼 수 있습니다.
가장 놀라운 점은 나바호어가 **분류 동사 어간(classificatory verb stems)**을 사용한다는 것입니다. ‘주다’, ‘떨어뜨리다’, ‘운반하다’에 해당하는 단일한 일반 동사가 없습니다. 대신 다루는 물체의 **물리적 모양, 재질, 그리고 생명체 여부(유정성)**에 따라 열두 가지의 완전히 다른 동사 어간 중에서 하나를 골라야 합니다.
문법 스포트라이트: 나바호어 분류 동사 (“그것을 나에게 주다”)
나바호어로 **“그것을 나에게 줘”**라고 말하고 싶다면, 물건이 어떻게 생겼는지에 따라 단어 끝의 동사 어간이 완전히 바뀝니다.
- 길고 단단한 물체 (펜, 막대기, 소총): Shaa nítį́ (어간: -tį́)
- 평평하고 유연한 물체 (종이 한 장, 담요, 지폐): Shaa níłtsóós (어간: -łtsóós)
- 둥글거나 부피감 있는 단일 물체 (공, 책, 사과): Shaa ní*’ą́*** (어간: -’ą́)
- 질척하거나 형태가 없는 물질 (진흙, 젖은 반죽): Shaa nítleeh (어간: -tleeh)
- 살아 있는 생명체 (강아지나 아기): Shaa níłteeh (어간: -łteeh)
스페인 북부와 프랑스 남서부 사이의 피레네산맥에서 쓰이는 바스크어는 지구상에 알려진 그 어떤 현존 언어와도 친족 관계가 없는 고립어(language isolate)—인도유럽어족 이전 시대의 생존자입니다.
완전히 독자적인 어휘 외에도 바스크어는 능격-절대격(ergative-absolutive) 문법 정렬을 사용합니다. 영어나 한국어, 그리고 거의 모든 유럽 언어에서는 동사에 목적어가 있든 없든 문장의 주어를 항상 같은 방식으로 취급합니다.
바스크어는 이 논리를 완전히 뒤집습니다. 바스크어에서는 자동사의 주어(“남자가 도착했다”)가 타동사의 직접목적어(“소년이 그 남자를 보았다”)와 정확히 똑같은 격(절대격)으로 표시되는 반면, 타동사 행위를 수행하는 사람에게는 특별한 **능격 접미사(-k)**가 붙습니다.
문법 스포트라이트: 바스크어의 능격-절대격 정렬
바스크어 단어 gizon(남자)과 mutil(소년)에 어떤 일이 일어나는지 보십시오.
- 자동사 문장: Gizona etorri da. (”그 남자가 도착했다.”)
- 여기서 gizon-a는 절대격(기본 명사 + 정관사 -a)입니다.
- 타동사 문장: Mutilak gizona ikusi du. ("그 소년이 그 남자를 보았다.")
- 여기서 “그 남자”(gizon-a)는 이제 직접목적어인데도, 그가 도착했을 때와 정확히 똑같은 절대격 형태(gizona)를 그대로 유지합니다!
- 반면 “그 소년”(mutila)은 다른 대상에게 행동을 가하는 주체이기 때문에 반드시 능격 접미사 -k를 취해 mutilak가 되어야 합니다.
주로 보츠와나와 나미비아에서 쓰이는 ǃXóõ어는 지구상 모든 언어 중 가장 많은 음소(phoneme) 목록을 보유한 세계 기록을 가지고 있습니다. 영어가 약 44개의 말소리(음소)로 충분한 반면, ǃXóõ어는 비음화, 유기음화, 성문음화 및 4개의 성조와 결합된 **80개 이상의 서로 다른 흡착음(클릭 자음)**을 포함해 무려 100개가 훌쩍 넘는 자음과 모음을 구분해 사용합니다. 심지어 언어 이름 맨 앞에 있는 느낌표 모양의 기호(ǃ)조차 혀를 입천장에서 아래로 튕기며 내는 치경 클릭음을 나타냅니다.
| FSI 등급 | 전일제 학습 기간 | 수업 시간 | 대표 언어 | 영어 원어민 기준 주요 병목 요인 |
|---|---|---|---|---|
| 카테고리 I (근연 언어) | 24–30주 | 552–690시간 | 스페인어, 프랑스어, 이탈리아어, 포르투갈어, 네덜란드어, 스웨덴어 | 간단한 동사 활용 및 문법적 성 |
| 카테고리 II (중간 거리) | ~36주 | 828시간 | 독일어, 인도네시아어, 말레이어, 스와힐리어 | 격 체계(독일어) 또는 낯선 어근 어휘(스와힐리어/인도네시아어) |
| 카테고리 III (고난도) | ~44주 | 1,012시간 | 러시아어, 폴란드어, 헝가리어, 핀란드어, 튀르키예어, 힌디어, 베트남어 | 방대한 명사 격변화, 교착성, 성조 또는 비라틴 문자 |
| 카테고리 IV (최고난도) | 88주 | 2,200시간 | 중국어(만다린·광둥어), 일본어, 한국어, 아랍어 | 표의문자/아브자드 문자, 성조 음운론, 양층언어 및 경어 체계 |
2,200시간의 학습 시간이나 18개의 문법 격을 보면 겁이 나는 것이 당연합니다. 하지만 베테랑 다국어 구사자(폴리글랏)들과 언어학자들은 한 가지 결정적인 비밀에 입을 모읍니다. 바로 동기부여와 매일의 꾸준함이 언어적 유사성을 언제나 이긴다는 사실입니다(특히 **기분에게 일정의 거부권을 주지 마라 **에서 다룬 ‘설계자 대 시공자’ 루틴 시스템과 결합할 때 더욱 그렇습니다).
일본 영화, 한국 음악, 혹은 아랍 역사에 깊은 열정을 가진 학습자는 기꺼이 2,000시간의 연습에 참여해 유창함에 도달하는 반면, 아무 관심도 없는 ‘카테고리 I’ 언어를 억지로 공부하는 사람은 50시간 만에 그만두고 맙니다. 중국어의 성조든, 헝가리어의 접미사든, 바스크어의 능격이든, 불가능해 보이는 모든 문법적 특징은 그저 인간의 마음이 현실을 조직하기 위해 찾아낸 또 하나의 경이로운 방식일 뿐입니다.
더 나은 삶을 위한 새로운 에세이, 도서 요약, 실전 가이드를 발행할 때 알림을 받아보세요. 스팸은 없으며 언제든 구독을 취소할 수 있습니다.
질문, 의견 또는 제안이 있으신가요? 아래에 생각을 남겨주세요. 댓글은 GitHub Discussions(광고 및 스팸 없음)를 통해 제공됩니다—댓글이나 반응을 남기려면 아래의 GitHub으로 로그인을 클릭하세요(무료 GitHub 계정은 1분 이내에 만들 수 있습니다).
최종 업데이트: 2026. 11. 13..
면책 조항: 본 사이트의 콘텐츠는 정보 제공 및 교육 목적으로만 제공되며 의학, 심리, 재무, 투자, 세무 또는 법률 자문을 구성하지 않습니다. 여기에 제시된 생각, 큐레이션 및 의견은 전적으로 저 개인의 것이며 고용주의 입장을 대변하지 않습니다. 도서, 강연 및 아티클 요약은 독립적인 교육적 해설이며 각 저자의 지적 재산입니다. 편집, 서식 지정 및 요약을 돕기 위해 AI 도구가 사용될 수 있으며, 정확성을 기하기 위해 최선을 다하고 있으나 오류가 포함될 수 있습니다. 개인정보 처리방침: 본 사이트는 선택적 뉴스레터 구독(Mailchimp), 댓글(giscus / GitHub Discussions) 및 임베디드 미디어(YouTube)를 위해 제3자 서비스를 사용하며, 해당 서비스들은 각자의 개인정보 처리방침에 따라 방문자의 IP 주소와 쿠키를 처리할 수 있습니다.