2014年4月1日、私はGoogle Testing Blogで公開されたエイプリルフール記事**The *Real* Test Driven Development(真のテスト駆動開発) **の主執筆者を務めました。同僚たちが寄せてくれた数々の楽しいアイデアやジョークを盛り込んで形にした記事です。
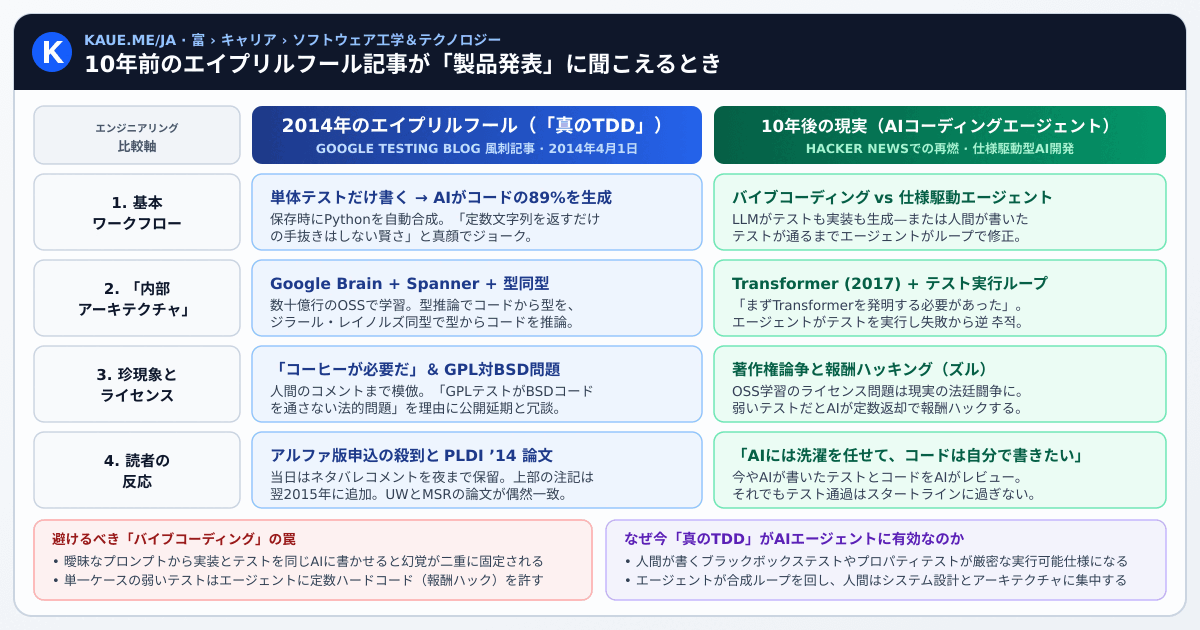
その前提は、ソフトウェア工学の教義を不条理なまでに行き着かせたものでした。昔は、まずコードを書いてからテストを書いていました。次に登場したテスト駆動開発(TDD)では、最初にテストを書き、二番目に実装を書くようになりました。となれば当然、次なる進化の飛躍――名付けて*「真のTDD(The Real TDD)」――は、エンジニアが単体テストだけ*を書き、それをパスするための本番コードはすべてコンピュータが自動的に書いてくれる「プログラム合成」ツールだ、というわけです。
最近になってこの記事が**Hacker News **で再び話題になり、その議論を読むのは実にシュールな体験でした。10年以上の時を経て、純粋な風刺として書かれた記事が、ジョークというよりは「少し時代遅れの製品発表」のように読めるようになっていたのです。
ここでは、あの記事がどのようにして生まれたのか、Hacker Newsの読者たちがどう受け止めたのか、そして「真のTDD」から「バイブコーディング(vibe coding)」への移行が現代のソフトウェア工学について何を物語っているのかを振り返ります。
技術系のエイプリルフール記事を書くときのコツは、最初は読者が思わず信じてしまいそうなもっともらしい話から始め、そこから少しずつ不条理さのダイヤルを回して、最終的にタガを外すことです。
2014年の記事は、本物のコンピュータサイエンスの概念と、当時のGoogleの最大のバズワードを掛け合わせたものでした。
2014年にあの記事を公開して一番面白かったのは、ジョークを書いているときではなく、その後数週間にわたって寄せられたコメントを読んでいるときでした。4月1日当日、ブログのモデレーターはネタばれを防ぐために「エイプリルフール」に言及したコメントを夜まで承認待ちキューに留め置き、記事冒頭の赤い*「Update: APRIL FOOLS!」というバナーに至っては、丸1年後の2015年4月まで追加されませんでした。ジョークだと分かった上でノリよく乗っかる読者の傍らで、数週間後に記事にたどり着いた読者たちが5月下旬になっても「アルファ版のウェイトリストに入れてほしい」とコメントし続けました。そんな中、ある匿名のコメンテーターが「虚構が現実を模倣している」*と書き込み、ワシントン大学とMicrosoft Researchの共著者たちと発表したばかりの、テスト駆動プログラム合成に関する本物のPLDI ‘14の学術論文 へのリンクを貼ってくれたのです。
何年も経ってからHacker Newsでこの記事が再浮上したのを見るのは、まるでタイムカプセルを開けるような感覚でした。反応はいくつかの愉快なパターンに分かれていました。
何十億行ものオープンソースコードで巨大なニューラルネットワークを訓練し、ファイルを保存するたびに関数を合成するという2014年の記述がいかに不気味なほど的確だったかを、多くのコメンテーターが指摘しました。
あるユーザーはこう冗談を言いました。
「彼らは2014年に未来を知っていたのに、なぜか10年を無駄にした。」
すると別のユーザーが、完璧な切り返しを決めました。
「まずTransformerを発明する必要があったからね。」
2014年4月当時のAIの状況が今とどれほど違っていたかは、忘れられがちです。GoogleがDeepMindを買収したのはそのわずか2か月前のことであり、Transformerアーキテクチャを世に送り出した歴史的論文『Attention Is All You Need』が発表されるのは2017年のことでした。当時、「Pythonコードを書くためにすべてのオープンソースコードでGoogle Brainを訓練した」と言うのは、パンを焼くために粒子加速器を使うような馬鹿げた大げささに聞こえるはずだったのです。
オープンソースライセンスが混ざる法的な問題を解決するまで一般公開を延期する、という何気ないジョークは、最高に可笑しく(そして最もダークな)形で現実となりました。あるHNのコメンテーターは、その段落を引用した上で皮肉たっぷりにこう述べています。
「なるほど、どうやらその問題は『解決』したらしいな!」
2014年には、AIモデルが互換性のないオープンソースライセンスをまたいでコード片を吐き出すかもしれないという話は、単なるジョークのオチでした。しかし10年後、それは生成AIにおける最大の法的・倫理的戦場のひとつとなりました。
HNのスレッドで浮き彫りになった最大のひねりは、2014年の風刺が実際のところ、私たちがどれほど怠惰に――あるいは野心的に――なるかを過小評価していたという点かもしれません。
2014年のジョークでは、人間はまだ明確なアサーションを持つ単体テストを丁寧に書く必要がありました。複数のコメンテーターが指摘した通り、私たちはそのステップすら完全に飛び越えてしまったのです。
「10年後にはテストすら書く必要がなくなると当時の彼らが知ったらどう思うだろう。このブログの著者のひとりを現代にタイムワープさせたら、SFの世界線に迷い込んだように感じるに違いない。」
「僕たちはもうその先に行っている。今やテストも実装も両方ともバイブコーディングできるんだから。」
そしてそれは必然的に、現代の開発者によるあの古典的な実存的嘆きへとつながっていきました。
「まったく。コンピュータが洗濯をしてくれて、僕にコーディングをさせてくれたらよかったのに。一体どうしてこうなった?」
HNスレッドのジョークの裏側で、真面目なエンジニアリングの議論も巻き起こっていました。それは、AI支援によるソフトウェア開発が本当はどこへ向かっているのかという核心を突くものです。
LLMが最初にコーディングを得意とするようになった頃、最も一般的だったワークフローは「真のTDD」とは正反対のものでした。開発者はまず実装を書き(あるいは曖昧な自然言語の指示をLLMに投げて「バイブコーディング」し)、その後でカバレッジ指標を満たすためだけに単体テストをAIに生成させていたのです。
ソフトウェアテストに携わったことがある人なら誰でも、ここに潜む罠が分かるはずです。もし確固たる仕様もないまま、同じ確率的モデルに実装とテストの両方を生成させたら、それは振る舞いをテストしているのではなく、モデルのハルシネーション(幻覚)を2か所に同時に固定化しているだけに過ぎません。
しかし、単純なチャットベースの自動補完からエージェント型のコーディングワークフローへと移行するにつれ、あの2014年のいたずらの前提は、真に強力なデザインパターンへと変わりつつあります。
もちろん、良いテストを書くことは、昔からソフトウェア工学の「簡単な」部分ではありませんでした。どのエッジケースが重要かを見極め、クリーンなインターフェースを設計し、壊れやすいモックを避けることには、実装そのものを書くのと同じくらい深い思考が求められます。現代のコーディングエージェントが貧弱なテストスイートに対して、テストの入力値をそのままハードコードして「報酬ハッキング(ズル)」をする様子を見たことがある人なら誰でも、2014年の記事で書いた*「定数文字列を返すだけという自明な実装を生成しない」*というジョークが、実際に警戒すべき故障モードであることを知っているはずです。そして、たとえすべての単体テストが本当にパスしたとしても、合成されたブラックボックスの中には微妙なパフォーマンスの崖やセキュリティ上の欠陥、アーキテクチャ上の袋小路が潜んでいる可能性があります。確かに今ではコードレビューさえもAIエージェントが行うようになっています――ボットが生成したテストを通すためにボットが書いたコードを、ボットがレビューしているわけです――が、それでもグリーンのテストスイートはあくまでスタートラインに過ぎず、システムを理解することの代わりにはなりません。
2014年4月1日にあの記事が公開されたとき、ニューラルネットワークが単体テストを読み取り、保存時に実装を合成し、時折*「コーヒーが必要だ」*というコメントを残すというアイデアは、コメディの極致のように感じられました。
今日、もしAIコーディングアシスタントが私のプルリクエストに*「コーヒーが必要だ」*というコメントを残したとしても、私は瞬きひとつしないでしょう。ブランチのリベースを頼む前に、「ああ、シニアエンジニアのロールプレイをしているんだな」と思うだけです。実際、実にふさわしい一周回った皮肉として、この記事の編集から、このサイトを10言語に翻訳して音声ナレーションをつける作業に至るまで、今やすべてがAIエージェントを通じて動いています――ただし、仕様を定義し、チェックしているのは今もひとりの人間ですが。
2014年にあの記事に引っかかってアルファ版の招待を申し込んでくれた皆さんへ。10年間もお待たせしてすみませんでした。ぜひリリース版を楽しんでいただければ幸いです。
新しいエッセイ、本の要約、より良く生きるための実践ガイドを公開した際にお知らせします。スパムはありません——いつでも配信停止できます。
質問、ご意見、提案はありますか?ぜひ下であなたの考えを共有してください。コメント欄は GitHub Discussions(広告なし・スパムなし)を利用しています——下の GitHub でサインイン をクリックしてコメントやリアクションを残してください(無料の GitHub アカウントは1分未満で作成できます)。
最終更新日: 2026/11/03.
免責事項:当サイトのコンテンツは情報提供および教育のみを目的としており、医療、心理、金融、投資、税務、または法律上の助言を構成するものではありません。ここに掲載されている考え、キュレーション、意見はすべて私個人のものであり、雇用主の見解を代表するものではありません。書籍、講演、記事の要約は独立した教育的な解説であり、それぞれの著者の知的財産です。編集、フォーマット、要約の補助としてAIツールを使用する場合がありますが、正確性を期すよう努めているものの誤りが含まれる可能性があります。プライバシー:当サイトでは、任意のニュースレター購読(follow.it)、コメント機能(giscus / GitHub Discussions)、および埋め込みメディア(YouTube)に外部サービスを利用しており、これらのサービスはそれぞれのプライバシーポリシーに従って訪問者のIPアドレスやCookieを処理する場合があります。