Il 1° aprile 2014 sono stato l’autore principale di un post per il pesce d’aprile sul Google Testing Blog intitolato The *Real* Test Driven Development , arricchito da diverse idee divertenti e battute suggerite dai colleghi.
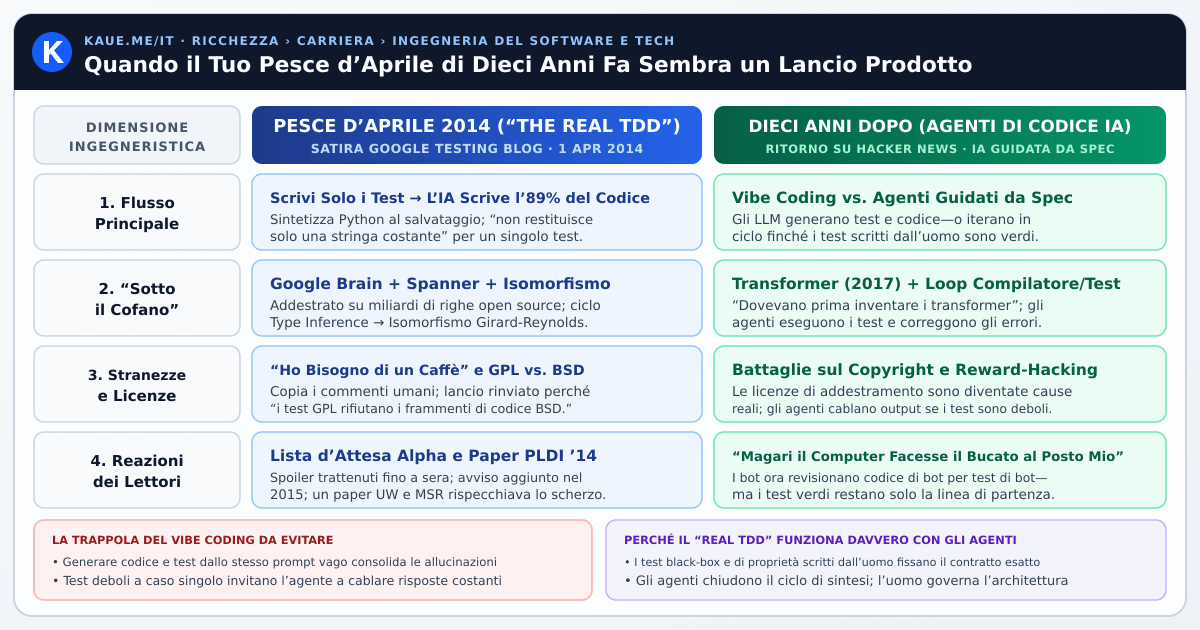
La premessa voleva essere un’escalation assurda del dogma dell’ingegneria del software. Ai vecchi tempi scrivevamo il codice e poi scrivevamo i test. Poi è arrivato il Test-Driven Development (TDD), in cui scrivevamo prima il test e poi l’implementazione. Naturalmente, il salto evolutivo successivo — ribattezzato The Real TDD — era uno strumento di “Sintesi dei Programmi” in cui gli ingegneri scrivevano solo i test unitari, e il computer scriveva automaticamente tutto il codice di produzione per farli passare.
Di recente il post è riemerso su Hacker News , e leggere la discussione è stata un’esperienza surreale. Più di un decennio dopo, un articolo scritto come pura satira si legge meno come uno scherzo e più come un annuncio di prodotto leggermente datato.
Ecco uno sguardo a come nacque quel post, a cosa ne ha tratto il pubblico di Hacker News e a ciò che la nostra transizione dal “Real TDD” al “vibe coding” dice sullo stato dell’ingegneria del software.
Quando scrivi un pesce d’aprile tecnico, l’obiettivo è partire da qualcosa di appena abbastanza plausibile da catturare il lettore, per poi alzare lentamente il livello di assurdità finché non salta tutto per aria.
Il post del 2014 mescolava autentici concetti di informatica con le più grandi parole d’ordine di Google dell’epoca:
La parte più divertente della pubblicazione di quel post nel 2014 non fu scrivere le battute, ma leggere i commenti nelle settimane successive. Il 1° aprile i moderatori del blog trattennero in coda fino a sera i commenti che menzionavano il “pesce d’aprile” per non rovinare lo scherzo, e l’avviso rosso “Update: APRIL FOOLS!” in cima fu aggiunto solo un anno intero dopo, nell’aprile 2015. Accanto ai lettori che stavano chiaramente al gioco, commentatori imbattutisi nel post settimane dopo continuarono a farsi vivi fino a fine maggio chiedendo di essere aggiunti alla lista d’attesa dell’alpha. Nel frattempo, un commentatore anonimo intervenne per far notare che “la finzione imita la realtà”, inserendo il link a un vero articolo accademico di PLDI ‘14 sulla Sintesi Guidata dai Test appena pubblicato insieme a coautori dell’Università di Washington e di Microsoft Research.
Vedere il post riemergere su Hacker News anni dopo è stato come aprire una capsula del tempo. Le reazioni si sono divise in alcuni filoni esilaranti:
Diversi commentatori hanno sottolineato quanto fosse impressionante leggere una descrizione del 2014 sull’addestramento di un’enorme rete neurale su miliardi di righe di codice open source per sintetizzare funzioni al salvataggio.
Un utente ha scherzato:
“Conoscevano il futuro nel 2014 e in qualche modo hanno sprecato 10 anni.”
Al che un altro ha risposto con la battuta definitiva:
“Dovevano prima inventare i transformer.”
È facile dimenticare quanto fosse diverso il panorama dell’IA nell’aprile 2014. Google aveva acquisito DeepMind solo due mesi prima, e lo storico articolo Attention Is All You Need che introdusse l’architettura Transformer non sarebbe stato pubblicato fino al 2017. All’epoca, dire “abbiamo addestrato Google Brain su tutto l’open source per scrivere codice Python” doveva suonare come usare un acceleratore di particelle per tostare il pane.
La battuta buttata lì sul rinvio del lancio finché non avessimo risolto le questioni legali legate alla mescolanza di licenze open source è invecchiata nel modo più divertente (e oscuro) possibile. Come ha osservato con asciutta ironia un commentatore su HN dopo aver citato quel paragrafo:
“Beh, a quanto pare le hanno risolte!”
Nel 2014, l’idea che un modello di IA potesse rigurgitare frammenti di codice attraverso licenze open source incompatibili era una battuta. Un decennio dopo, è diventata uno dei campi di battaglia legali ed etici decisivi dell’IA generativa.
Forse il colpo di scena più grande catturato nel thread di HN è che la satira del 2014 aveva in realtà sottovalutato quanto saremmo diventati pigri — o ambiziosi.
Nello scherzo, gli esseri umani dovevano comunque scrivere con cura test unitari dotati di asserzioni chiare. Come hanno fatto notare diversi commentatori, abbiamo saltato del tutto quel passaggio:
“Se solo avessero saputo che 10 anni dopo non c’è nemmeno più bisogno di scrivere i test. Dev’essere come finire in una linea temporale di fantascienza se teletrasportassi uno degli autori di questo blog nel nostro futuro.”
“Siamo oltre, ora possiamo fare ‘vibecode’ sia dei test che dell’implementazione.”
Il che ha inevitabilmente portato al classico lamento esistenziale dello sviluppatore moderno:
“Ragazzi, vorrei che il computer facesse il bucato e lasciasse a me la programmazione. Cos’è successo qui?”
Sotto le battute del thread di HN è emersa una discussione ingegneristica seria, che va dritta al cuore della direzione verso cui si sta davvero muovendo lo sviluppo software assistito dall’IA.
Quando gli LLM sono diventati bravi a programmare per la prima volta, il flusso di lavoro più comune era l’esatto opposto del “Real TDD”. Gli sviluppatori scrivevano l’implementazione (o chiedevano a un LLM con una vaga descrizione in linguaggio naturale di farne il “vibe coding”) e poi chiedevano all’IA di generare i test unitari a posteriori solo per soddisfare le metriche di copertura.
Chiunque abbia lavorato nel testing del software conosce la trappola: se lo stesso modello probabilistico genera sia la tua implementazione sia i tuoi test senza una specifica solida, non stai testando il comportamento — stai solo consacrando le allucinazioni del modello in due posti contemporaneamente.
Tuttavia, man mano che passiamo dal semplice autocompletamento via chat ai flussi di lavoro di programmazione ad agenti, la premessa di quello scherzo del 2014 si sta trasformando in un pattern progettuale autenticamente potente:
Naturalmente, scrivere buoni test non è mai stata la parte “facile” dell’ingegneria del software. Sapere quali casi limite contano, progettare interfacce pulite ed evitare mock fragili richiede un pensiero profondo tanto quanto scrivere l’implementazione stessa. Chiunque abbia visto un moderno agente di codice fare “reward-hacking” su una suite di test debole cablando direttamente gli input esatti del test sa bene che la nostra battuta del 2014 sul “non generare l’implementazione ovvia che restituisce una stringa costante” descrive una reale modalità di guasto da cui bisogna difendersi. E anche quando tutti i test unitari passano davvero, una scatola nera sintetizzata può comunque nascondere sottili crolli prestazionali, falle di sicurezza o vicoli ciechi architetturali. Certo, ormai abbiamo agenti di IA che fanno anche le code review — bot che revisionano il codice che i bot hanno scritto per superare i test che i bot hanno generato —, ma una suite di test verde resta solo la linea di partenza, non un sostituto della comprensione del sistema.
Quando quel post andò online il 1° aprile 2014, l’idea di una rete neurale che leggeva i tuoi test unitari, sintetizzava l’implementazione al salvataggio e lasciava occasionalmente un commento con scritto “Ho bisogno di un caffè” sembrava il culmine della comicità.
Oggi, se un assistente di programmazione IA lasciasse un commento “Ho bisogno di un caffè” nella mia pull request, non batterei nemmeno ciglio: darei semplicemente per scontato che stia interpretando il ruolo di un ingegnere senior prima di chiedergli di fare il rebase del mio branch. In effetti, con una perfetta ironia che chiude il cerchio, tutto — dall’editing di questo post alla traduzione e narrazione di questo sito in dieci lingue — passa ormai attraverso agenti di IA, guidati da un essere umano che definisce e controlla ancora le specifiche.
A tutti coloro che caddero nello scherzo del post nel 2014 e chiesero un invito per l’alpha: scusate per i dieci anni di attesa, e spero che vi stiate godendo il rilascio.
Ricevi una notifica quando pubblico nuovi saggi, riassunti di libri e guide pratiche per vivere bene. Niente spam—annulla l'iscrizione in qualsiasi momento.
Scarica l'edizione offline di Lo Stile di Vita di Kaue—una guida pratica per ottimizzare 🍏 Salute, 💰 Ricchezza, ❤️ Amore e 🧘 Significato.
Hai una domanda, una prospettiva o un suggerimento? Condividi i tuoi pensieri qui sotto. I commenti utilizzano GitHub Discussions (senza pubblicità e senza spam)—clicca su Accedi con GitHub qui sotto per commentare o reagire (creare un account GitHub gratuito richiede meno di un minuto).
Aggiornato il 3 nov 2026.
AVVERTENZA LEGALE: Il contenuto di questo sito ha scopo esclusivamente informativo ed educativo e non costituisce consulenza medica, psicologica, finanziaria, di investimento, fiscale o legale. Le idee, la selezione e le opinioni qui presentate sono esclusivamente mie e non rappresentano quelle del mio datore di lavoro. I riassunti di libri, conferenze e articoli sono commenti educativi indipendenti e rimangono proprietà intellettuale dei rispettivi autori. Strumenti di IA possono essere utilizzati per assistere nella revisione, formattazione e sintesi; sebbene venga compiuto ogni sforzo per garantire l'accuratezza, possono verificarsi errori. PRIVACY: Questo sito utilizza servizi di terze parti per l'iscrizione facoltativa alla newsletter (follow.it), i commenti (giscus / GitHub Discussions) e i contenuti multimediali incorporati (YouTube), che possono trattare gli indirizzi IP e i cookie dei visitatori in conformità con le rispettive informative sulla privacy.