यदि आपने कभी सुबह काम पर जाते समय किसी ऐप पर स्पेनिश या फ्रेंच सीखने की कोशिश की है, तो आपने शायद कुछ जाना-पहचाना और आश्वस्त करने वाला महसूस किया होगा। familia या information जैसे शब्द अंग्रेज़ी जैसे ही दिखते हैं, वाक्य आमतौर पर एक परिचित क्रम का पालन करते हैं, और वर्णमाला बिल्कुल वही रोमन लिपि है जिसे पढ़ते हुए आप बड़े हुए हैं।
अब एक ऐसी पाठ्यपुस्तक खोलने की कल्पना कीजिए जहाँ लिपि दाएँ से बाएँ चलती है और अधिकांश स्वरों (vowels) को छोड़ देती है, या जहाँ एक ही क्रिया बारह अलग-अलग रूपों में बदल जाती है—इस बात पर निर्भर करते हुए कि आप किसी को कागज़ का एक पन्ना दे रहे हैं, एक छड़ी दे रहे हैं, या एक पिल्ला।
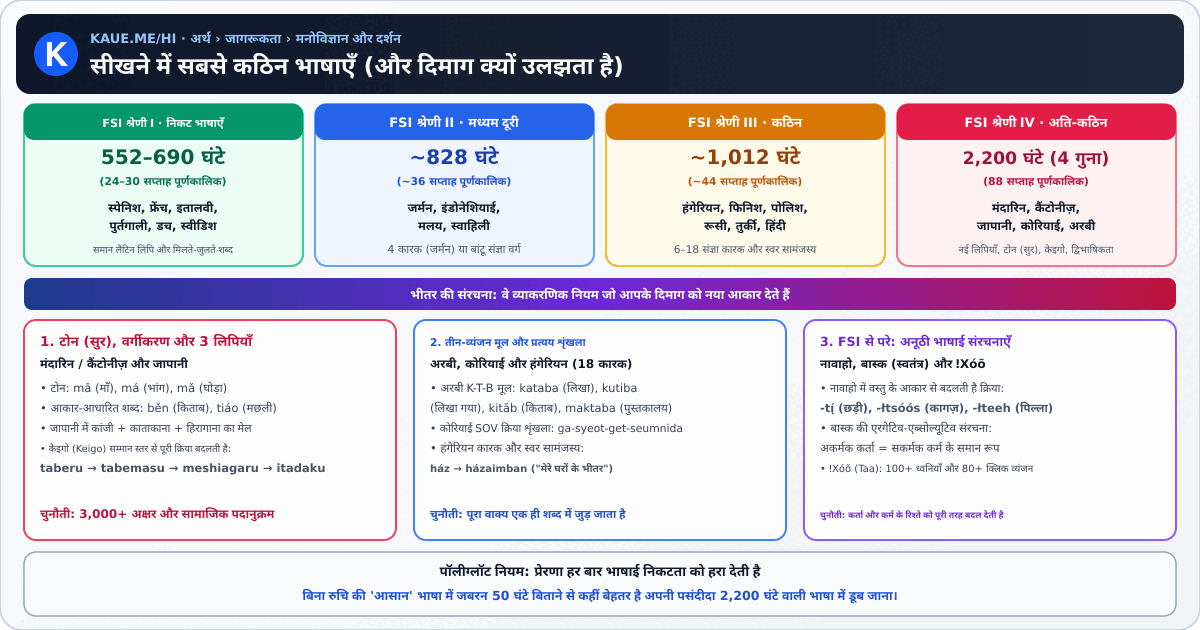
अंग्रेज़ी बोलने वालों के लिए सीखने में पाँच सबसे कठिन प्रमुख भाषाएँ मंदारिन चीनी, कैंटोनीज़, अरबी, जापानी और कोरियाई हैं। अमेरिकी राजनयिकों को प्रशिक्षित करने वाली संस्था यू.एस. फॉरेन सर्विस इंस्टीट्यूट (FSI) के अनुसार, इन “श्रेणी IV” (अति-कठिन) भाषाओं में कामकाजी दक्षता हासिल करने के लिए लगभग 88 सप्ताह (2,200 कक्षा घंटे) के गहन अध्ययन की आवश्यकता होती है। यह स्पेनिश, इतालवी या डच जैसी रोमांस या जर्मेनिक भाषाओं की तुलना में लगभग चार गुना अधिक समय है, जिनमें 552 से 690 कक्षा घंटे लगते हैं।
विशुद्ध रूप से बाल-विकास के दृष्टिकोण से, कोई भी भाषा वस्तुनिष्ठ रूप से दूसरी से कठिन नहीं होती; टोक्यो, बुडापेस्ट और काहिरा में नन्हे बच्चे लगभग एक ही गति से अपनी मातृभाषा में महारत हासिल करते हैं। हालाँकि, वयस्क शिक्षार्थियों के लिए कठिनाई का सीधा संबंध भाषाई दूरी (linguistic distance) से है: कोई लक्ष्य भाषा लेखन, ध्वनि प्रणाली, शब्दावली, सांस्कृतिक संदर्भ और—सबसे प्रमुख रूप से—व्याकरण में आपकी मातृभाषा से कितनी भिन्न है (ठीक उन गहरे ऐतिहासिक बदलावों की तरह जिनकी पड़ताल हमने कैसे सुकरात का ‘दैमोन’ ईसाई धर्म का ‘दानव’ (Demon) बन गया और गणित से मीम्स तक: ‘-Maxxing’ की चौंकाने वाली उत्पत्ति में की थी)।
आइए दुनिया की सबसे कठिन भाषाओं का विश्लेषण करें और उन विशिष्ट व्याकरणिक नियमों को समझें जो उन्हें इतना चुनौतीपूर्ण बनाते हैं।
FSI की शीर्ष श्रेणी की प्रत्येक भाषा मस्तिष्क के सामने अलग तरह की संज्ञानात्मक चुनौतियाँ पेश करती है।
पहली नज़र में, चीनी व्याकरण आश्चर्यजनक रूप से सरल लगता है: इसमें कोई क्रिया रूप-परिवर्तन (conjugation) नहीं है, कोई व्याकरणिक लिंग नहीं है, संज्ञाओं के बहुवचन रूप नहीं हैं, और यूरोपीय अर्थों में कोई काल (tense) भी नहीं है। इसके बजाय, असली कठिनाई इसकी टोनल ध्वनि प्रणाली (सुर/तान), चित्रलिपि (logographic writing system), और सूक्ष्म आस्पेक्ट कणों (aspect particles) तथा मापक शब्दों (classifiers) में निहित है।
मंदारिन में 4 मुख्य टोन (और एक तटस्थ टोन) का उपयोग होता है, जबकि कैंटोनीज़ में वर्गीकरण के आधार पर 6 से 9 टोन होते हैं। आवाज़ के उतार-चढ़ाव में ज़रा-सा बदलाव किसी अक्षर के अर्थ को पूरी तरह बदल देता है। इसके अलावा, अख़बार पढ़ने के लिए 3,000 से 4,000 अलग-अलग अक्षरों (Hanzi) को याद करना पड़ता है, जो उनके उच्चारण के बारे में बहुत कम ध्वन्यात्मक संकेत देते हैं।
व्याकरण स्पॉटलाइट: टोन, मापक शब्द और काल-बोध
पहला, मंदारिन में आवाज़ की तान (pitch) शब्द का अर्थ पूरी तरह बदल देती है:
- mā (妈 – उच्च समतल तान): माँ
- má (麻 – चढ़ती हुई तान): भांग / सुन्न
- mǎ (馬 – गिरकर उठती तान): घोड़ा
- mà (骂 – गिरती हुई तान): डाँटना / गाली देना
दूसरा, आप चीनी में संज्ञाओं को सीधे नहीं गिन सकते (जैसे “एक किताब” या “तीन कुत्ते”)। वस्तु के आकार या प्रकृति के आधार पर संख्या और संज्ञा के बीच एक विशिष्ट वर्गीकरण शब्द (measure word / classifier) लगाना अनिवार्य है:
- yī běn shū (一本书): एक [बंधी-हुई-पुस्तक-का-मापक] किताब
- yī tiáo yú (一条鱼): एक [लंबी-लचीली-वस्तु-का-मापक] मछली
- yī zhāng zhuōzi (一张桌子): एक [सपाट-सतह-का-मापक] मेज़
अंत में, चूँकि क्रियाएँ काल के अनुसार कभी रूप नहीं बदलतीं, इसलिए संदर्भ और le (了) या guo (过) जैसे आस्पेक्ट कण समय का भार उठाते हैं:
- Wǒ chī fàn (我吃饭): मैं चावल खाता हूँ / खा रहा हूँ। (शाब्दिक अर्थ: “मैं खाना भोजन।”)
- Wǒ chī le fàn (我吃了饭): मैंने भोजन कर लिया। (यहाँ le भूतकाल को नहीं, बल्कि ‘कार्य की पूर्णता’ को दर्शाता है—इसका उपयोग भविष्य के लिए भी किया जा सकता है, जैसे “जब मैं खाना खा लूँगा…”)
FSI द्वारा श्रेणी IV के भीतर भी सबसे अधिक समय लेने वाली भाषा के रूप में वर्णित, जापानी में एक ही वाक्य के भीतर एक साथ तीन अलग-अलग लेखन प्रणालियों का तालमेल बिठाना पड़ता है:
पढ़ने के अलावा, जापानी वाक्य कर्ता-कर्म-क्रिया (SOV) क्रम में चलते हैं (जैसे हिंदी में), परसर्गों (particles) पर निर्भर करते हैं, और शिष्टाचार तथा सम्मानजनक भाषा (Keigo) की एक बेहद जटिल प्रणाली लागू करते हैं, जहाँ सामाजिक पदानुक्रम के आधार पर क्रियाएँ और शब्दावली पूरी तरह बदल जाती हैं।
व्याकरण स्पॉटलाइट: तीन लिपियाँ + सामाजिक पदानुक्रम (Keigo)
देखिए एक साधारण वाक्य में तीनों लेखन प्रणालियाँ कैसे एक साथ आती हैं: “मैंने कैफ़े में कॉफ़ी पी।”
- 私はカフェでコーヒーを飲みました。 (Watashi wa kafe de kōhī o nomimashita.)
- 私 (Watashi – “मैं”) और 飲 (no- – “पीना” की धातु) कांजी में लिखे गए हैं।
- カフェ (kafe – “कैफ़े”) और コーヒー (kōhī – “कॉफ़ी”) विदेशी शब्द हैं जो काताकाना में लिखे गए हैं।
- は (wa – विषय सूचक), で (de – स्थान सूचक “में”), を (o – कर्म कारक चिह्न), और みました (mimashita – विनम्र भूतकालिक क्रिया अंत) हिरागाना में लिखे गए हैं।
अब देखिए कि आप किससे बात कर रहे हैं, इसके आधार पर “खाना / पीना” (taberu / nomu) जैसी मूल क्रिया के साथ क्या होता है:
- अनौपचारिक (करीबी दोस्त से): Taberu (食べる)
- विनम्र (सामान्य दैनिक बोलचाल): Tabemasu (食べます)
- सम्मानजनक (Sonkeigo – बॉस या ग्राहक के कार्य को सम्मान देते हुए): Meshiagaru (召し上がる)
- विनत (Kenjōgo – वरिष्ठ के सामने अपने कार्य को विनम्र बनाते हुए): Itadaku (いただく)
क्रिया में केवल एक विनम्र प्रत्यय नहीं जुड़ता—वह पूरी तरह से एक अलग शब्द में बदल जाती है!
अरबी दाएँ से बाएँ एक अबजद (abjad) लिपि में लिखी जाती है, जहाँ अक्षर शब्द के शुरू, बीच या अंत में आने के आधार पर अपना आकार बदल लेते हैं, और दैनिक पुस्तकों व समाचार पत्रों में छोटे स्वर (short vowels) छोड़ दिए जाते हैं। किसी शब्द का सही उच्चारण करने के लिए भी आपको अक्सर उस शब्द और वाक्य में उसकी व्याकरणिक भूमिका को पहले से जानना पड़ता है।
हालाँकि, इसकी सबसे बड़ी व्यावहारिक बाधा द्विभाषिक स्थिति (diglossia) है: आधुनिक मानक अरबी (MSA, जो समाचारों, साहित्य और औपचारिक भाषणों में प्रयुक्त होती है) बोलचाल की क्षेत्रीय बोलियों (जैसे मिस्री, लेवेंटाइन या मोरक्कन अरबी) से काफी भिन्न होती है। शिक्षार्थियों को प्रभावी रूप से एक साथ भाषा के दो रूपों का अध्ययन करना पड़ता है।
व्याकरण स्पॉटलाइट: तीन-व्यंजन मूल प्रणाली (Triconsonantal Root System)
भारोपीय भाषाओं के विपरीत, जो एक स्थिर मूल शब्द में उपसर्ग और प्रत्यय जोड़कर नए शब्द बनाती हैं (जैसे act → active → reactivation), अरबी गैर-श्रृंखलाबद्ध रूपविज्ञान (non-concatenative morphology) का उपयोग करती है। अधिकांश शब्द तीन व्यंजनों के एक कंकाल (जड़) के इर्द-गिर्द बने होते हैं जिसमें एक मूल अवधारणा होती है। उस कंकाल के भीतर और चारों ओर विभिन्न स्वर पैटर्न और व्यंजन बुनकर शब्दों का एक पूरा परिवार तैयार किया जाता है।
मूल K – T – B (ك - ت - ب) को लीजिए, जिसमें “लिखने” की मुख्य अवधारणा है:
- KaTaBa (kataba): उसने लिखा (भूतकाल सक्रिय क्रिया)
- KuTiBa (kutiba): वह लिखा गया (भूतकाल कर्मवाच्य क्रिया—केवल आंतरिक स्वरों से बदल गई!)
- KiTāB (kitāb): किताब
- KuTuB (kutub): किताबें (अंत में प्रत्यय जोड़ने के बजाय आंतरिक स्वरों को बदलकर बनाया गया बहुवचन)
- KāTiB (kātib): लेखक
- maKTaB (maktab): मेज़ / कार्यालय (उपसर्ग ma- कार्य के स्थान को दर्शाता है)
- maKTaBa (maktaba): पुस्तकालय / बुकस्टोर
विडंबना यह है कि कोरियाई भाषा के पास वह लिपि है जिसे भाषाविद् दुनिया की सबसे आसान और सबसे तार्किक लेखन प्रणाली मानते हैं: हंगुल (Hangul), जो 1443 में राजा सेजोंग द्वारा तैयार की गई एक ध्वन्यात्मक वर्णमाला है और जिसे एक ही दोपहर में सीखा जा सकता है।
वर्णमाला सीखने के ठीक बाद असली कठिनाई शुरू होती है। जापानी और हिंदी की तरह कोरियाई भी कर्ता-कर्म-क्रिया (SOV) वाक्य-विन्यास का उपयोग करती है, जिसका अर्थ है कि क्रिया हमेशा वाक्य के बिल्कुल अंत में आती है। इसके अलावा, कोरियाई अत्यधिक योगात्मक (agglutinative) भाषा है, जो काल, भाव, प्रेरणार्थक रूप और शिष्टाचार के सात अलग-अलग स्तरों को व्यक्त करने के लिए क्रिया धातुओं के पीछे प्रत्ययों की लंबी शृंखला जोड़ती है।
व्याकरण स्पॉटलाइट: योगात्मक क्रिया शृंखला और शिष्टाचार स्तर
अंग्रेज़ी या हिंदी में हम क्रिया को संशोधित करने के लिए सहायक शब्दों (“शायद चले गए होंगे”) का उपयोग करते हैं। कोरियाई में, वे सभी अवधारणाएँ सीधे क्रिया धातु 가- (ga-, “जाना”) के साथ जोड़ दी जाती हैं:
- 가다 (ga-da): जाना (शब्दकोश रूप)
- 가시었다 → 가셨다 (ga-si-eot-da): गए (सम्मानित व्यक्ति के लिए आदरसूचक चिह्न -si- + भूतकाल -eot-)
- 가셨겠습니다 (ga-syeot-get-seumnida): "[एक सम्मानित व्यक्ति] शायद चले गए होंगे।"
- 가- (ga-): मूल धातु (“जाना”)
- -시- (-si-): कर्ता आदरसूचक चिह्न (जाने वाले व्यक्ति को सम्मान देना)
- -었- (-eot-): भूतकाल चिह्न
- -겠- (-get-): अनुमान / संभावना चिह्न (“शायद / अवश्य”)
- -습니다 (-seumnida): श्रोता के प्रति औपचारिक विनम्र समापन
भाषाई दीवार से टकराने के लिए आपको रोमन लिपि छोड़ने की भी ज़रूरत नहीं है। श्रेणी III की भाषाओं के लिए लगभग 44 सप्ताह (1,012 कक्षा घंटे) के गहन अध्ययन की आवश्यकता होती है और ये अपने भूलभुलैया जैसे व्याकरणिक रूप-परिवर्तनों के लिए प्रसिद्ध हैं।
स्पेनिश और अंग्रेज़ी से लेकर रूसी और यूनानी तक लगभग सभी यूरोपीय भाषाएँ भारोपीय (Indo-European) परिवार से संबंधित हैं (जिसमें हिंदी और संस्कृत भी शामिल हैं)। लेकिन हंगेरियन, फिनिश और एस्टोनियाई इससे संबंधित नहीं हैं। वे यूरालिक भाषा परिवार से आती हैं, जिसका अर्थ है कि उनकी मूल शब्दावली यूरोपीय भाषाओं से बिल्कुल मेल नहीं खाती और वे एक पूरी तरह से अलग व्याकरणिक ढाँचे पर काम करती हैं: भारी प्रत्यय-संयोजन (agglutination), स्वर सामंजस्य (vowel harmony), और 14 से 18 व्याकरणिक कारक (cases)।
संज्ञा के साथ अलग से परसर्ग या पूर्वसर्ग लगाने के बजाय, यूरालिक भाषाएँ शब्द के अंत में एक के बाद एक प्रत्यय चिपकाती जाती हैं। इसके अलावा, स्वर सामंजस्य के कारण, प्रत्येक प्रत्यय के कई रूप (अग्र-स्वर बनाम पश्च-स्वर) होते हैं ताकि पूरे शब्द के स्वर ध्वन्यात्मक रूप से मेल खाएँ।
व्याकरण स्पॉटलाइट: हंगेरियन कारक संयोजन और स्वर सामंजस्य
देखिए कैसे हंगेरियन संज्ञा ház (घर) एक ही शब्द में पूरे वाक्यांश को समाहित कर लेती है:
- ház: घर
- házak: अनेक घर (बहुवचन -ak)
- házaim: मेरे घर (बहुवचन) (संबंधवाचक बहुवचन -aim)
- házaimban: मेरे घरों में (“के भीतर” के अर्थ में इनेसिव कारक प्रत्यय -ban)
- házaimból: मेरे घरों के भीतर से बाहर (“अंदर से बाहर” के अर्थ में इलेटिव कारक प्रत्यय -ból)
चूँकि ház में पश्च-स्वर (á) है, इसलिए इसमें पश्च-स्वर प्रत्यय -ban (“में”) लगता है। यदि आप kert (बगीचा) शब्द का उपयोग करते हैं, जिसमें अग्र-स्वर (e) है, तो स्वर सामंजस्य के कारण प्रत्यय बदलकर -ben हो जाता है: kertemben (मेरे बगीचे में)।
रूसी (6 कारक) और पोलिश (7 कारक) जैसी स्लाविक भाषाएँ वाक्य के हर एक शब्द के सटीक व्याकरणिक कार्य को ट्रैक करने के लिए मजबूर करती हैं। अंग्रेज़ी में शब्दों का क्रम बताता है कि किसने क्या किया (“The dog bit the man” का अर्थ “The man bit the dog” के विपरीत होता है)।
पोलिश और रूसी में, संज्ञा के अंतिम प्रत्यय बताते हैं कि किसने क्या किया, जिसका अर्थ है कि ज़ोर देने के लिए शब्दों के क्रम को किसी भी तरह बदला जा सकता है जबकि हर संज्ञा, विशेषण, सर्वनाम और यहाँ तक कि संख्या का प्रत्यय भी बदल जाता है। इसके अतिरिक्त, स्लाविक क्रियाएँ आस्पेक्ट जोड़ों (अपूर्ण बनाम पूर्ण) में आती हैं, जिसके कारण लगभग हर क्रिया के लिए दो अलग-अलग क्रियापद सीखने पड़ते हैं।
व्याकरण स्पॉटलाइट: पोलिश के 7 कारकों में “काली बिल्ली” के रूप
देखिए कैसे “काली बिल्ली” (czarny kot) वाक्यांश पोलिश के 7 व्याकरणिक कारकों में बदलता है:
- कर्ता कारक (Nominative): Czarny kot śpi. (काली बिल्ली सो रही है।)
- संबंध/निषेध कारक (Genitive): Nie widzę czarnego kota. (मुझे काली बिल्ली नहीं दिख रही है।)
- संप्रदान कारक (Dative): Daję mleko czarnemu kotu. (मैं काली बिल्ली को दूध देता हूँ।)
- कर्म कारक (Accusative): Widzę czarnego kota. (मैं काली बिल्ली को देखता हूँ।)
- करण कारक (Instrumental): Idę z czarnym kotem. (मैं काली बिल्ली के साथ चल रहा हूँ।)
- अधिकरण कारक (Locative): Mówię o czarnym kocie. (मैं काली बिल्ली के बारे में बात कर रहा हूँ।)
- संबोधन कारक (Vocative): O, czarny kocie! (अरे, काली बिल्ली!)
ध्यान दीजिए कि अधिकरण और संबोधन कारकों में मूल शब्द का अंतिम व्यंजन भी -t से बदलकर -ci- (kot → kocie) हो जाता है!
उत्तरी अटलांटिक में अपने भौगोलिक अलगाव के कारण, 9वीं शताब्दी में नॉर्स बसने वालों के आने के बाद से आइसलैंडिक भाषा में बहुत कम बदलाव आया है। आधुनिक आइसलैंडवासी आज भी मध्ययुगीन वाइकिंग गाथाओं (Viking Sagas) को आसानी से पढ़ सकते हैं। हालाँकि, शिक्षार्थियों के लिए इसका अर्थ है प्राचीन ओल्ड नॉर्स व्याकरण में महारत हासिल करना: चार कारक, तीन लिंग, अत्यधिक अनियमित क्रिया रूप, 1 से 4 तक की संख्याएँ जो लिंग और कारक के अनुसार बदलती हैं, और भाषाई शुद्धता की नीति जो विदेशी शब्दों के बजाय प्राचीन यौगिक शब्दों का निर्माण करती है (उदाहरण के लिए, “कंप्यूटर” के लिए tölva, जो “संख्या” और “भविष्यवक्ता” शब्दों के मेल से बना है)।
FSI केवल उन भाषाओं को रैंक करता है जो राजनयिकों को नियमित रूप से पढ़ाई जाती हैं। मानक राजनयिक पाठ्यक्रम से बाहर, दुनिया की कई भाषाएँ मानव व्याकरण को ऐसे क्षेत्रों में ले जाती हैं जो बिल्कुल अनूठे लगते हैं।
द्वितीय विश्व युद्ध के दौरान अमेरिकी मरीन कॉर्प्स द्वारा एक अभेद्य कोड के रूप में प्रसिद्ध रूप से उपयोग की गई नावाहो, अमेरिकी दक्षिण-पश्चिम में बोली जाने वाली एक बहुसंश्लेषणात्मक (polysynthetic), क्रिया-प्रधान भाषा है। नावाहो की एक अकेली क्रिया पूरे वाक्य जितनी जानकारी समेट सकती है।
सबसे उल्लेखनीय बात यह है कि नावाहो में वर्गीकरण क्रिया धातुओं (classificatory verb stems) का उपयोग होता है: “देना”, “गिराना” या “ले जाना” के लिए कोई एक सामान्य क्रिया नहीं है। इसके बजाय, आपको वस्तु के भौतिक आकार, बनावट और सजीवता के आधार पर दर्जन भर पूरी तरह से अलग क्रिया धातुओं में से चुनाव करना पड़ता है।
व्याकरण स्पॉटलाइट: नावाहो की वर्गीकरण क्रियाएँ (“मुझे दो…”)
यदि आप नावाहो में “यह मुझे दो” कहना चाहते हैं, तो वस्तु कैसी दिखती है, इसके आधार पर शब्द के अंत की क्रिया धातु पूरी तरह बदल जाती है:
- लंबी, कठोर वस्तु (पेन, छड़ी या राइफल): Shaa nítį́ (धातु: -tį́)
- सपाट, लचीली वस्तु (कागज़ की शीट, कंबल या नोट): Shaa níłtsóós (धातु: -łtsóós)
- एकल गोल या भारी वस्तु (गेंद, किताब या सेब): Shaa ní*’ą́*** (धातु: -’ą́)
- गीला या आकारहीन पदार्थ (कीचड़ या गीला आटा): Shaa nítleeh (धातु: -tleeh)
- सजीव प्राणी (पिल्ला या बच्चा): Shaa níłteeh (धातु: -łteeh)
उत्तरी स्पेन और दक्षिण-पश्चिमी फ्रांस के बीच पिरेनीज़ पर्वतों में बोली जाने वाली बास्क एक भाषा आइसोलेट (language isolate) है—पृथ्वी पर किसी भी अन्य ज्ञात जीवित भाषा से असंबंधित एक पूर्व-भारोपीय भाषा।
अपनी अनूठी शब्दावली के अलावा, बास्क एक पूर्णकालिक एरगेटिव-एब्सोल्यूटिव (ergative-absolutive) व्याकरणिक संरचना का उपयोग करती है। अंग्रेज़ी (और अधिकांश यूरोपीय भाषाओं) में, वाक्य के कर्ता के साथ हमेशा एक जैसा व्यवहार किया जाता है, चाहे क्रिया का कोई कर्म हो या न हो:
बास्क इस तर्क को पूरी तरह से बदल देती है (हिंदी के भूतकालिक ‘ने’ परसर्ग को हर काल में लागू करने की तरह, लेकिन और भी गहराई से)। बास्क में, अकर्मक क्रिया के कर्ता (“आदमी आया”) को सकर्मक क्रिया के प्रत्यक्ष कर्म (“लड़के ने आदमी को देखा”) के बिल्कुल समान रूप (एब्सोल्यूटिव कारक) में रखा जाता है, जबकि सकर्मक कार्य करने वाले व्यक्ति के साथ एक विशेष एरगेटिव प्रत्यय (-k) जुड़ता है।
व्याकरण स्पॉटलाइट: बास्क में एरगेटिव-एब्सोल्यूटिव संरेखण
बास्क शब्दों gizon (आदमी) और mutil (लड़का) के साथ क्या होता है, देखिए:
- अकर्मक वाक्य: Gizona etorri da. ("आदमी आ गया है।")
- यहाँ, gizon-a एब्सोल्यूटिव कारक में है (मूल संज्ञा + -a “वह/निश्चित”)।
- सकर्मक वाक्य: Mutilak gizona ikusi du. ("लड़के ने आदमी को देखा है।")
- यहाँ, “आदमी” (gizon-a) अब प्रत्यक्ष कर्म है, फिर भी वह बिल्कुल वही एब्सोल्यूटिव रूप (gizona) बनाए रखता है जो उसके आने पर था!
- वहीं, “लड़का” (mutila), चूँकि वह किसी दूसरे पर कार्य कर रहा है, इसलिए उसे एरगेटिव प्रत्यय -k लेना पड़ता है: mutilak.
मुख्य रूप से बोत्सवाना और नामीबिया में बोली जाने वाली ǃXóõ भाषा के पास पृथ्वी की किसी भी भाषा की तुलना में सबसे बड़े ध्वनि-भंडार (phoneme inventory) का विश्व रिकॉर्ड है। जहाँ अंग्रेज़ी लगभग 44 ध्वनियों और हिंदी लगभग 45–50 ध्वनियों से काम चला लेती है, वहीं ǃXóõ में 100 से अधिक अलग-अलग व्यंजन और स्वर हैं, जिनमें अनुनासिकता, महाप्राणता, काकल्यीकरण और चार टोन के साथ 80 से अधिक अलग-अलग क्लिक व्यंजन (चटखारे की ध्वनियाँ) शामिल हैं। इसके नाम की शुरुआत में विस्मयादिबोधक चिह्न जैसा दिखने वाला प्रतीक (ǃ) भी तालु से जीभ को नीचे झटककर निकाली जाने वाली क्लिक ध्वनि को दर्शाता है।
| FSI श्रेणी | पूर्णकालिक अध्ययन | कक्षा घंटे | प्रतिनिधि भाषाएँ | अंग्रेज़ी भाषियों के लिए मुख्य चुनौती |
|---|---|---|---|---|
| श्रेणी I (निकट संबंधी) | 24–30 सप्ताह | 552–690 घंटे | स्पेनिश, फ्रेंच, इतालवी, पुर्तगाली, डच, स्वीडिश | सामान्य क्रिया रूप और व्याकरणिक लिंग |
| श्रेणी II (मध्यम दूरी) | ~36 सप्ताह | 828 घंटे | जर्मन, इंडोनेशियाई, मलय, स्वाहिली | कारक प्रणाली (जर्मन) या अपरिचित मूल शब्दावली (स्वाहिली/इंडोनेशियाई) |
| श्रेणी III (कठिन) | ~44 सप्ताह | 1,012 घंटे | रूसी, पोलिश, हंगेरियन, फिनिश, तुर्की, हिंदी, वियतनामी | विस्तृत संज्ञा कारक, प्रत्यय-संयोजन, टोन या गैर-रोमन लिपियाँ |
| श्रेणी IV (अति-कठिन) | 88 सप्ताह | 2,200 घंटे | मंदारिन, कैंटोनीज़, जापानी, कोरियाई, अरबी | चित्रलिपि/अबजद लिपियाँ, टोनल ध्वनि प्रणाली, द्विभाषिकता और सम्मान प्रणाली |
जब आप 2,200 घंटे के अध्ययन या 18 व्याकरणिक कारकों को देखते हैं, तो घबरा जाना स्वाभाविक है। हालाँकि, अनुभवी बहुभाषाविद (polyglots) और भाषाविद् एक महत्वपूर्ण रहस्य पर सहमत हैं: प्रेरणा और दैनिक निरंतरता हर बार भाषाई निकटता को हरा देती है (विशेषकर जब इसे अपने मूड को अपनी दिनचर्या पर वोट न करने दें की आर्किटेक्ट-बनाम-बिल्डर प्रणाली के साथ जोड़ा जाए)।
एक शिक्षार्थी जो जापानी सिनेमा, कोरियाई संगीत या अरबी इतिहास के प्रति गहरा जुनून रखता है, वह खुशी-खुशी 2,000 घंटे का अभ्यास करेगा और धाराप्रवाह बोलना सीख लेगा, जबकि कोई व्यक्ति जो बिना किसी रुचि के खुद को “श्रेणी I” की भाषा पढ़ने के लिए मजबूर कर रहा है, वह 50 घंटे बाद ही छोड़ देगा। हर “असंभव” व्याकरणिक विशेषता—चाहे वह चीनी टोन हो, हंगेरियन प्रत्यय हो या बास्क एरगेटिविटी—केवल वास्तविकता को व्यवस्थित करने का एक अलग और अद्भुत तरीका है जिसे मानव मस्तिष्क ने खोजा है।
जब भी मैं बेहतर जीवन जीने पर नए निबंध, पुस्तक सारांश और व्यावहारिक गाइड प्रकाशित करूँ, तो सूचना प्राप्त करें। कोई स्पैम नहीं—कभी भी सदस्यता समाप्त करें।
काउए की जीवनशैली का क्यूरेटेड ऑफ़लाइन संस्करण प्राप्त करें—🍏 स्वास्थ्य, 💰 धन, ❤️ प्रेम और 🧘 अर्थ को बेहतर बनाने के लिए एक व्यावहारिक मार्गदर्शिका।
क्या आपका कोई प्रश्न, दृष्टिकोण या सुझाव है? नीचे अपने विचार साझा करें। टिप्पणियाँ GitHub Discussions (विज्ञापन-मुक्त और स्पैम-मुक्त) द्वारा संचालित हैं—टिप्पणी करने या प्रतिक्रिया देने के लिए नीचे Sign in with GitHub पर क्लिक करें (निःशुल्क GitHub खाता बनाने में एक मिनट से भी कम समय लगता है)।
अंतिम अपडेट: 13 नव॰ 2026.
अस्वीकरण (DISCLAIMER): इस साइट की सामग्री केवल सूचनात्मक और शैक्षिक उद्देश्यों के लिए है और यह चिकित्सा, मनोवैज्ञानिक, वित्तीय, निवेश, कर या कानूनी सलाह का गठन नहीं करती है। यहाँ प्रस्तुत विचार, संकलन और राय पूरी तरह से मेरे अपने हैं और मेरे नियोक्ता का प्रतिनिधित्व नहीं करते हैं। पुस्तकों, व्याख्यानों और लेखों के सारांश स्वतंत्र शैक्षिक टिप्पणियाँ हैं और उनके संबंधित लेखकों की बौद्धिक संपदा बने रहते हैं। संपादन, स्वरूपण और संश्लेषण में सहायता के लिए AI उपकरणों का उपयोग किया जा सकता है; यद्यपि सटीकता सुनिश्चित करने का हर संभव प्रयास किया जाता है, फिर भी त्रुटियाँ हो सकती हैं। गोपनीयता (PRIVACY): यह साइट वैकल्पिक न्यूज़लेटर सदस्यता (Mailchimp), टिप्पणियों (giscus / GitHub Discussions) और एम्बेडेड मीडिया (YouTube) के लिए तृतीय-पक्ष सेवाओं का उपयोग करती है, जो अपनी संबंधित गोपनीयता नीतियों के अनुसार आगंतुकों के IP पते और कुकीज़ को संसाधित कर सकती हैं।