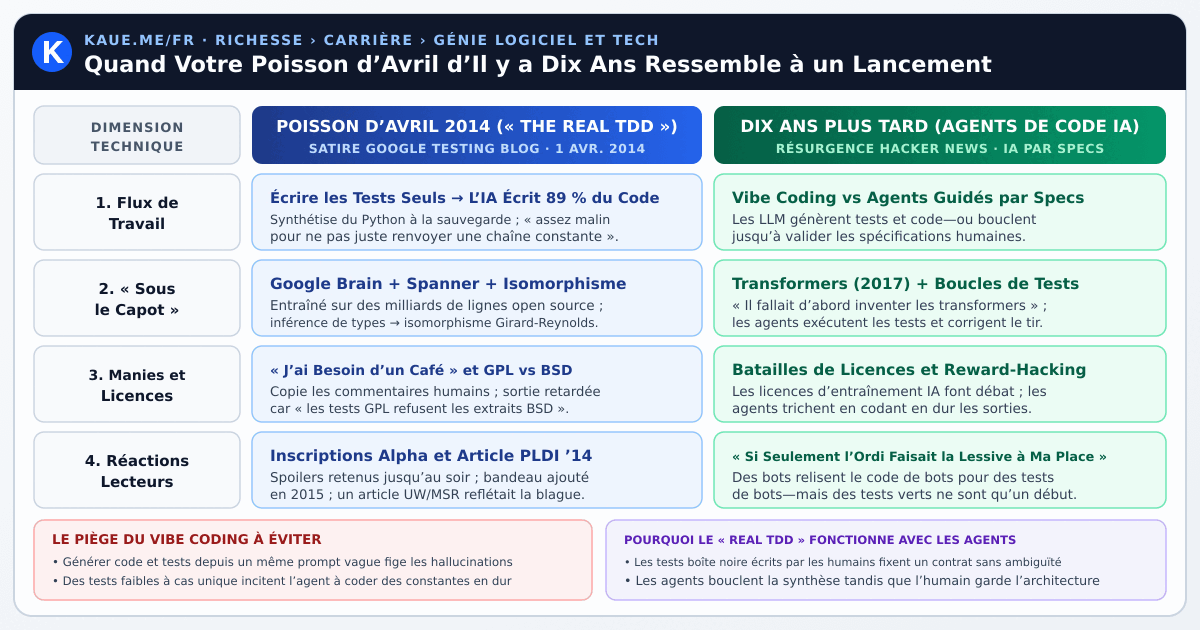
Le 1er avril 2014, j’ai été l’auteur principal d’un billet de poisson d’avril sur le Google Testing Blog intitulé The *Real* Test Driven Development , enrichi de plusieurs idées amusantes et traits d’esprit proposés par des collègues.
Le point de départ se voulait une escalade absurde du dogme du génie logiciel. Autrefois, nous écrivions le code, puis les tests. Ensuite est arrivé le développement piloté par les tests (TDD), où nous écrivions d’abord le test et ensuite l’implémentation. Naturellement, le bond évolutif suivant — baptisé The Real TDD — était un outil de « synthèse de programmes » où les ingénieurs écrivaient uniquement les tests unitaires, et où l’ordinateur écrivait automatiquement tout le code de production pour les faire passer.
Récemment, le billet a refait surface sur Hacker News , et parcourir la discussion a été une expérience surréaliste. Plus d’une décennie plus tard, un texte écrit comme une pure satire se lit moins comme une blague que comme une annonce de produit légèrement datée.
Voici un retour sur la genèse de ce billet, ce que la communauté Hacker News en a pensé et ce que notre transition du « Real TDD » au « vibe coding » révèle sur l’état du génie logiciel.
Lorsqu’on écrit un poisson d’avril technique, l’objectif est de partir d’un postulat juste assez plausible pour ferrer le lecteur avant d’augmenter progressivement l’absurdité jusqu’à ce que tout déraille.
Le billet de 2014 mêlait de véritables concepts d’informatique aux plus grands mots à la mode chez Google à l’époque :
La partie la plus drôle de la publication de ce billet en 2014 n’a pas été d’écrire les blagues, mais de lire les commentaires au cours des semaines suivantes. Le 1er avril, les modérateurs du blog ont retenu jusqu’au soir les commentaires mentionnant « poisson d’avril » afin de ne pas gâcher la plaisanterie, et le bandeau rouge « Update: APRIL FOOLS! » tout en haut n’a été ajouté qu’un an plus tard, en avril 2015. Aux côtés des lecteurs qui jouaient clairement le jeu, des commentateurs tombés sur l’article plusieurs semaines après ont continué à se manifester jusqu’à la fin du mois de mai pour demander à être inscrits sur la liste d’attente de la version alpha. Parallèlement, un commentateur anonyme est intervenu pour souligner que « la fiction imite la réalité », en partageant le lien vers un véritable article académique de PLDI ‘14 sur la synthèse pilotée par les tests qu’il venait de publier avec des coauteurs de l’Université de Washington et de Microsoft Research.
Voir ce billet refaire surface sur Hacker News des années plus tard donnait l’impression d’ouvrir une capsule temporelle. Les réactions se sont réparties en quelques grandes catégories savoureuses :
Plusieurs commentateurs ont souligné à quel point il était troublant de lire une description datant de 2014 sur l’entraînement d’un immense réseau neuronal sur des milliards de lignes de code open source pour synthétiser des fonctions à chaque sauvegarde.
Un utilisateur a plaisanté :
« Ils connaissaient l’avenir en 2014 et ont d’une manière ou d’une autre perdu 10 ans. »
Ce à quoi un autre a répondu avec une répartie parfaite :
« Ils devaient d’abord inventer les transformers. »
On oublie facilement à quel point le paysage de l’IA était différent en avril 2014. Google avait racheté DeepMind à peine deux mois plus tôt, et l’article fondateur Attention Is All You Need, qui a introduit l’architecture Transformer, ne serait publié qu’en 2017. À l’époque, dire « nous avons entraîné Google Brain sur tout l’open source pour écrire du code Python » était censé paraître aussi disproportionné que d’utiliser un accélérateur de particules pour griller du pain.
La blague lancée à la légère sur le report du lancement le temps de régler la légalité du mélange des licences open source a vieilli de la manière la plus drôle (et la plus sombre) qui soit. Comme l’a sèchement observé un commentateur sur HN après avoir cité ce paragraphe :
« Eh bien, on dirait qu’ils ont fini par régler ça ! »
En 2014, l’idée qu’un modèle d’IA puisse régurgiter des extraits issus de licences open source incompatibles était une chute humoristique. Une décennie plus tard, c’est devenu l’un des champs de bataille juridiques et éthiques majeurs de l’IA générative.
Le plus grand retournement de situation capturé dans le fil HN est peut-être que la satire de 2014 avait en réalité sous-estimé à quel point nous deviendrions paresseux — ou ambitieux.
Dans la blague, les humains devaient encore rédiger soigneusement des tests unitaires avec des assertions claires. Comme plusieurs commentateurs l’ont fait remarquer, nous avons complètement sauté cette étape :
« S’ils avaient su que 10 ans plus tard, on n’aurait même plus besoin d’écrire de tests. Ça doit ressembler à de la science-fiction si l’on téléportait l’un des auteurs de ce blog dans notre futur. »
« Nous avons dépassé ça, maintenant nous pouvons “vibecoder” à la fois les tests et l’implémentation. »
Ce qui a inévitablement conduit à la complainte existentielle classique du développeur moderne :
« Franchement, j’aimerais que l’ordinateur fasse la lessive et me laisse coder. Qu’est-ce qui s’est passé ici ? »
Derrière les plaisanteries du fil HN, une discussion technique sérieuse a émergé — qui touche au cœur de la direction que prend réellement le développement logiciel assisté par l’IA.
Lorsque les LLM sont devenus performants en programmation, le flux de travail le plus courant était l’exact opposé du « Real TDD ». Les développeurs écrivaient l’implémentation (ou demandaient à un LLM via une description vague en langage naturel de la « vibecoder »), puis demandaient ensuite à l’IA de générer des tests unitaires uniquement pour satisfaire les métriques de couverture.
Quiconque a travaillé dans le test logiciel connaît le piège : si le même modèle probabiliste génère à la fois votre implémentation et vos tests sans spécification solide, vous ne testez pas le comportement — vous ne faites que graver dans le marbre les hallucinations du modèle à deux endroits en même temps.
Cependant, à mesure que nous passons de la simple autocomplétion par chat à des flux de travail de programmation par agents, le postulat de ce canular de 2014 devient un véritable modèle de conception :
Bien sûr, écrire de bons tests n’a jamais été la partie « facile » du génie logiciel. Savoir quels cas limites comptent, concevoir des interfaces propres et éviter des mocks fragiles exige une réflexion tout aussi profonde que d’écrire l’implémentation elle-même. Quiconque a déjà observé un agent de programmation moderne pratiquer le « reward-hacking » sur une suite de tests trop faible en codant en dur les entrées exactes du test sait que notre blague de 2014 sur un outil « assez intelligent pour ne pas générer l’implémentation évidente consistant à renvoyer une chaîne constante » décrit un véritable mode de défaillance dont il faut se prémunir. Et même lorsque tous les tests unitaires passent réellement, une boîte noire synthétisée peut encore cacher de subtils gouffres de performance, des failles de sécurité ou des impasses architecturales. Certes, nous avons désormais aussi des agents d’IA qui effectuent les revues de code — des robots qui relisent le code que des robots ont écrit pour passer les tests que des robots ont générés —, mais une suite de tests au vert reste uniquement la ligne de départ, et non un substitut à la compréhension du système.
Lorsque ce billet a été mis en ligne le 1er avril 2014, l’idée d’un réseau neuronal lisant vos tests unitaires, synthétisant l’implémentation à la sauvegarde et laissant parfois un commentaire disant « J’ai besoin d’un café » ressemblait au sommet de la comédie.
Aujourd’hui, si un assistant de code IA laissait un commentaire « J’ai besoin d’un café » dans ma pull request, je ne sourcillerais même pas — je supposerais simplement qu’il joue le rôle d’un ingénieur senior avant de lui demander de rebaser ma branche. En fait, dans une belle ironie de boucle bouclée, tout — de l’édition de ce billet à la traduction et la narration de ce site en dix langues — passe désormais par des agents d’IA, guidés par un humain qui définit et vérifie toujours les spécifications.
À toutes celles et ceux qui se sont laissé prendre au jeu en 2014 et ont demandé une invitation pour l’alpha : désolé pour ces dix ans d’attente, et j’espère que vous profitez bien de la sortie.
Recevez une notification lorsque je publie de nouveaux essais, résumés de livres et guides pratiques pour bien vivre. Sans spam—désabonnez-vous à tout moment.
Obtenez l'édition hors ligne de Le Mode de Vie de Kaue—un guide pratique pour optimiser 🍏 Santé, 💰 Richesse, ❤️ Amour et 🧘 Sens.
Vous avez une question, une perspective ou une suggestion ? Partagez vos réflexions ci-dessous. Les commentaires fonctionnent avec GitHub Discussions (sans publicité et sans spam)—cliquez sur Se connecter avec GitHub ci-dessous pour commenter ou réagir (créer un compte GitHub gratuit prend moins d'une minute).
Mis à jour le 3 nov. 2026.
AVERTISSEMENT : Le contenu de ce site est fourni à titre purement informatif et éducatif et ne constitue pas un avis médical, psychologique, financier, d'investissement, fiscal ou juridique. Les idées, la sélection et les opinions présentées ici n'engagent que moi et ne représentent pas celles de mon employeur. Les résumés de livres, de conférences et d'articles sont des commentaires éducatifs indépendants et restent la propriété intellectuelle de leurs auteurs respectifs. Des outils d'IA peuvent être utilisés pour aider à l'édition, à la mise en forme et à la synthèse ; bien que tous les efforts soient déployés pour garantir l'exactitude, des erreurs peuvent survenir. CONFIDENTIALITÉ : Ce site utilise des services tiers pour l'abonnement facultatif à la newsletter (follow.it), les commentaires (giscus / GitHub Discussions) et les médias intégrés (YouTube), qui peuvent traiter les adresses IP et les cookies des visiteurs conformément à leurs politiques de confidentialité respectives.