El 1 de abril de 2014, fui el autor principal de una publicación del Día de los Inocentes (April Fools’) en el Google Testing Blog titulada The *Real* Test Driven Development , enriquecida con varias ideas divertidas y remates aportados por compañeros de trabajo.
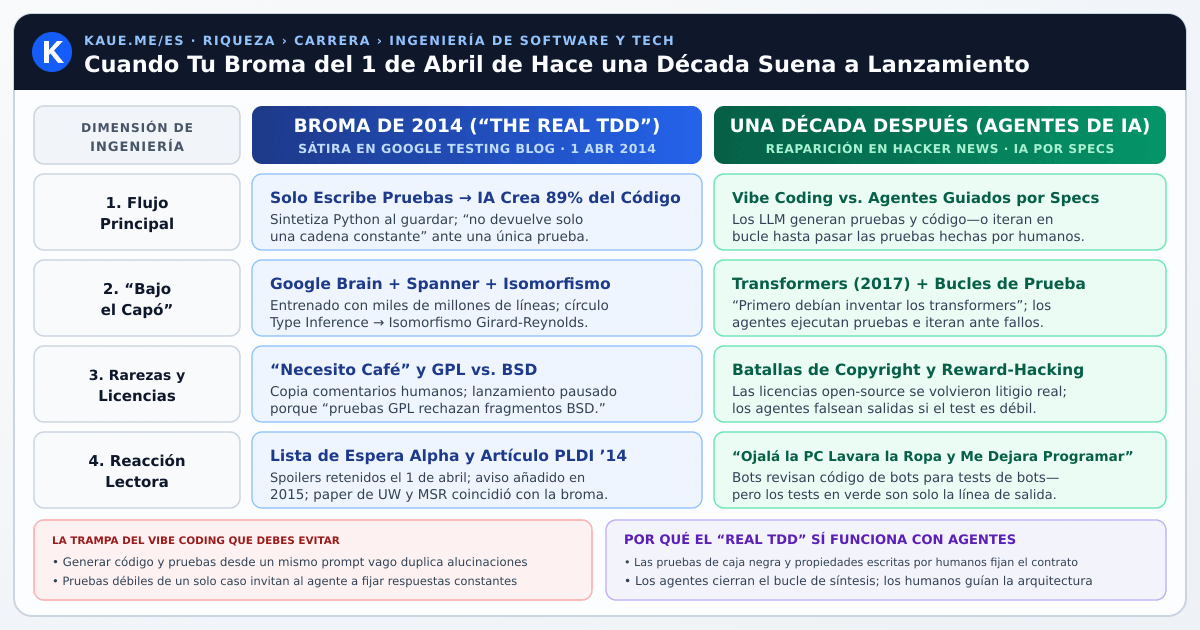
La premisa pretendía ser una escalada absurda del dogma de la ingeniería de software. En los viejos tiempos, escribíamos el código y luego escribíamos las pruebas. Después llegó el Desarrollo Guiado por Pruebas (TDD), donde escribíamos primero la prueba y en segundo lugar la implementación. Naturalmente, el siguiente salto evolutivo —bautizado como The Real TDD— era una herramienta de “Síntesis de Programas” en la que los ingenieros escribían únicamente las pruebas unitarias, y la computadora escribía automáticamente todo el código de producción para hacerlas pasar.
Recientemente, el artículo resurgió en Hacker News , y leer el debate fue una experiencia surrealista. Más de una década después, una publicación escrita como pura sátira se lee menos como un chiste y más como el anuncio ligeramente anticuado de un producto.
Aquí tienes un vistazo a cómo se gestó aquel artículo, qué opinó la comunidad de Hacker News y qué dice nuestra transición del “Real TDD” al “vibe coding” sobre el estado de la ingeniería de software.
Cuando escribes una broma técnica para el 1 de abril, el objetivo es empezar en un punto lo bastante plausible como para enganchar al lector antes de subir poco a poco el nivel de absurdo hasta que todo se descarrila.
El artículo de 2014 mezclaba conceptos genuinos de ciencias de la computación con las palabras de moda más grandes de Google en aquella época:
La parte más divertida de publicar ese artículo en 2014 no fue escribir los chistes, sino leer los comentarios durante las semanas siguientes. El 1 de abril, los moderadores del blog retuvieron hasta la noche los comentarios que mencionaban “April Fools’” para no arruinar la broma, y el aviso rojo “Update: APRIL FOOLS!” en la parte superior no se añadió hasta un año entero después, en abril de 2015. Junto a los lectores que claramente siguieron el juego, siguieron apareciendo comentaristas que se toparon con el artículo semanas más tarde, hasta finales de mayo, pidiendo que los añadieran a la lista de espera de la versión alfa. Mientras tanto, un comentarista anónimo intervino para señalar que “la ficción imita a la vida real”, enlazando un artículo académico real de PLDI ‘14 sobre Síntesis Guiada por Pruebas que acababan de publicar con coautores de la Universidad de Washington y Microsoft Research.
Ver reaparecer la publicación en Hacker News años después se sintió como abrir una cápsula del tiempo. Las reacciones se dividieron en unas cuantas categorías divertidísimas:
Varios comentaristas señalaron lo asombroso que resultaba leer una descripción de 2014 sobre el entrenamiento de una enorme red neuronal con miles de millones de líneas de código abierto para sintetizar funciones al guardar.
Un usuario bromeó:
“Conocían el futuro en 2014 y de alguna manera desperdiciaron 10 años.”
A lo que otro respondió con el remate definitivo:
“Primero tenían que inventar los transformers.”
Es fácil olvidar lo diferente que era el panorama de la IA en abril de 2014. Google había adquirido DeepMind apenas dos meses antes, y el histórico artículo Attention Is All You Need, que introdujo la arquitectura Transformer, no se publicaría hasta 2017. En aquel entonces, decir “entrenamos a Google Brain con todo el código abierto para escribir código en Python” pretendía sonar como usar un acelerador de partículas para tostar pan.
El chiste casual sobre retrasar el lanzamiento hasta resolver los aspectos legales de mezclar licencias de código abierto envejeció de la manera más divertida (y oscura) posible. Como observó con ironía un comentarista de HN tras citar ese párrafo:
"¡Bueno, parece que ya los resolvieron!"
En 2014, la idea de que un modelo de IA pudiera regurgitar fragmentos combinando licencias de código abierto incompatibles era un chiste. Una década más tarde, se convirtió en uno de los campos de batalla legales y éticos decisivos de la IA generativa.
Quizás el mayor giro capturado en el hilo de HN es que la sátira de 2014 en realidad subestimó cuán perezosos —o ambiciosos— llegaríamos a ser.
En la broma, los humanos aún tenían que diseñar cuidadosamente pruebas unitarias con aserciones claras. Como señalaron varios comentaristas, nos saltamos ese paso por completo:
“Si supieran que 10 años después ya ni siquiera necesitas escribir pruebas. Debe sentirse como una línea temporal de ciencia ficción si teletransportaras a uno de los autores de este blog a nuestro futuro.”
“Ya hemos superado eso, ahora podemos hacer ‘vibecode’ tanto de las pruebas como de la implementación.”
Lo que inevitablemente condujo al clásico lamento existencial del desarrollador moderno:
“Hombre. Ojalá la computadora lavara la ropa y me dejara programar a mí. ¿Qué ha pasado aquí?”
Debajo de las bromas en el hilo de HN, surgió un debate serio de ingeniería que va directo al corazón de hacia dónde se dirige realmente el desarrollo de software asistido por IA.
Cuando los LLM empezaron a ser buenos programando, el flujo de trabajo más común era exactamente el opuesto al “Real TDD”. Los desarrolladores escribían la implementación (o le pedían a un LLM con una descripción vaga en lenguaje natural que hiciera “vibe coding”) y luego le pedían a la IA que generara pruebas unitarias a posteriori solo para cumplir con las métricas de cobertura.
Cualquiera que haya trabajado en pruebas de software conoce la trampa: si el mismo modelo probabilístico genera tanto tu implementación como tus pruebas sin una especificación fundamentada, no estás probando el comportamiento, sino consagrando las alucinaciones del modelo en dos lugares a la vez.
Sin embargo, a medida que pasamos del simple autocompletado por chat a flujos de trabajo de programación con agentes, la premisa de aquella broma de 2014 se está convirtiendo en un patrón de diseño genuinamente poderoso:
Por supuesto, escribir buenas pruebas nunca ha sido la parte “fácil” de la ingeniería de software. Saber qué casos límite importan, diseñar interfaces limpias y evitar mocks frágiles requiere tanto pensamiento profundo como escribir la propia implementación. Cualquiera que haya visto a un agente de programación moderno hacer “reward-hacking” en una suite de pruebas débil codificando directamente las entradas exactas de la prueba sabe que nuestro chiste de 2014 sobre “no generar la implementación obvia de devolver una cadena constante” es un modo de fallo real contra el que hay que protegerse. E incluso cuando todas las pruebas unitarias pasan de verdad, una caja negra sintetizada aún puede ocultar sutiles abismos de rendimiento, fallos de seguridad o callejones sin salida arquitectónicos. Claro, ahora también tenemos agentes de IA haciendo las revisiones de código —bots revisando el código que escribieron bots para pasar las pruebas que generaron bots—, pero una suite de pruebas en verde sigue siendo solo la línea de salida, no un sustituto de comprender el sistema.
Cuando aquella publicación salió a la luz el 1 de abril de 2014, la idea de una red neuronal leyendo tus pruebas unitarias, sintetizando la implementación al guardar y dejando ocasionalmente un comentario que decía “Necesito un café” parecía la cumbre de la comedia.
Hoy en día, si un asistente de programación con IA dejara un comentario de “Necesito un café” en mi pull request, ni siquiera parpadearía: simplemente asumiría que está interpretando el papel de un ingeniero sénior antes de pedirle que haga un rebase de mi rama. De hecho, en una oportuna ironía de círculo completo, todo —desde la edición de este artículo hasta la traducción y narración de este sitio en diez idiomas— pasa ahora por agentes de IA, guiados por un humano que sigue definiendo y verificando las especificaciones.
A todos los que cayeron en la broma del artículo en 2014 y pidieron una invitación para la versión alfa: perdón por la espera de diez años, y espero que estén disfrutando del lanzamiento.
Recibe notificaciones cuando publique nuevos ensayos, resúmenes de libros y guías prácticas sobre cómo vivir bien. Sin spam—cancela cuando quieras.
Obtén la edición sin conexión de El Estilo de Vida de Kaue—una guía práctica para optimizar 🍏 Salud, 💰 Riqueza, ❤️ Amor y 🧘 Sentido.
¿Tienes alguna pregunta, perspectiva o sugerencia? Comparte tus ideas abajo. Los comentarios funcionan con GitHub Discussions (sin anuncios y sin spam)—haz clic en Iniciar sesión con GitHub abajo para comentar o reaccionar (crear una cuenta gratuita en GitHub toma menos de un minuto).
Actualizado el 3 nov 2026.
AVISO LEGAL: El contenido de este sitio tiene fines exclusivamente informativos y educativos y no constituye asesoramiento médico, psicológico, financiero, de inversión, fiscal ni legal. Las ideas, la selección y las opiniones aquí presentadas son exclusivamente mías y no representan las de mi empleador. Los resúmenes de libros, conferencias y artículos son comentarios educativos independientes y siguen siendo propiedad intelectual de sus respectivos autores. Se pueden utilizar herramientas de IA para ayudar en la edición, el formato y la síntesis; aunque se hace todo lo posible por garantizar la precisión, pueden producirse errores. PRIVACIDAD: Este sitio utiliza servicios de terceros para la suscripción opcional al boletín (follow.it), los comentarios (giscus / GitHub Discussions) y el contenido multimedia incrustado (YouTube), que pueden procesar las direcciones IP y las cookies de los visitantes de acuerdo con sus respectivas políticas de privacidad.