Am 1. April 2014 war ich der Hauptautor eines Aprilscherz-Beitrags auf dem Google Testing Blog mit dem Titel The *Real* Test Driven Development , der durch mehrere witzige Ideen und Pointen von Kollegen mitgestaltet wurde.
Die Prämisse war als absurde Zuspitzung eines Software-Engineering-Dogmas gedacht. Früher schrieben wir zuerst den Code und danach die Tests. Dann kam die testgetriebene Entwicklung (Test-Driven Development, TDD), bei der wir zuerst den Test und als Zweites die Implementierung schrieben. Folgerichtig war der nächste evolutionäre Sprung – getauft auf den Namen The Real TDD – ein Werkzeug zur „Programmsynthese“, bei dem Entwickler nur noch die Unit-Tests schrieben und der Computer automatisch den gesamten Produktionscode generierte, damit diese Tests bestanden wurden.
Kürzlich tauchte der Beitrag auf Hacker News wieder auf, und das Lesen der Diskussion war eine surreale Erfahrung. Mehr als ein Jahrzehnt später liest sich ein als reine Satire verfasster Text weniger wie ein Witz, sondern eher wie eine leicht angegraute Produktankündigung.
Hier ist ein Rückblick darauf, wie dieser Beitrag damals entstand, was die Hacker-News-Community daraus machte und was unser Übergang von „Real TDD“ zu „Vibe Coding“ über den Zustand der Softwareentwicklung verrät.
Wenn man einen technischen Aprilscherz schreibt, besteht das Ziel darin, gerade plausibel genug anzufangen, um den Leser an den Haken zu bekommen, bevor man die Absurdität langsam so weit hochdreht, bis alles völlig entgleist.
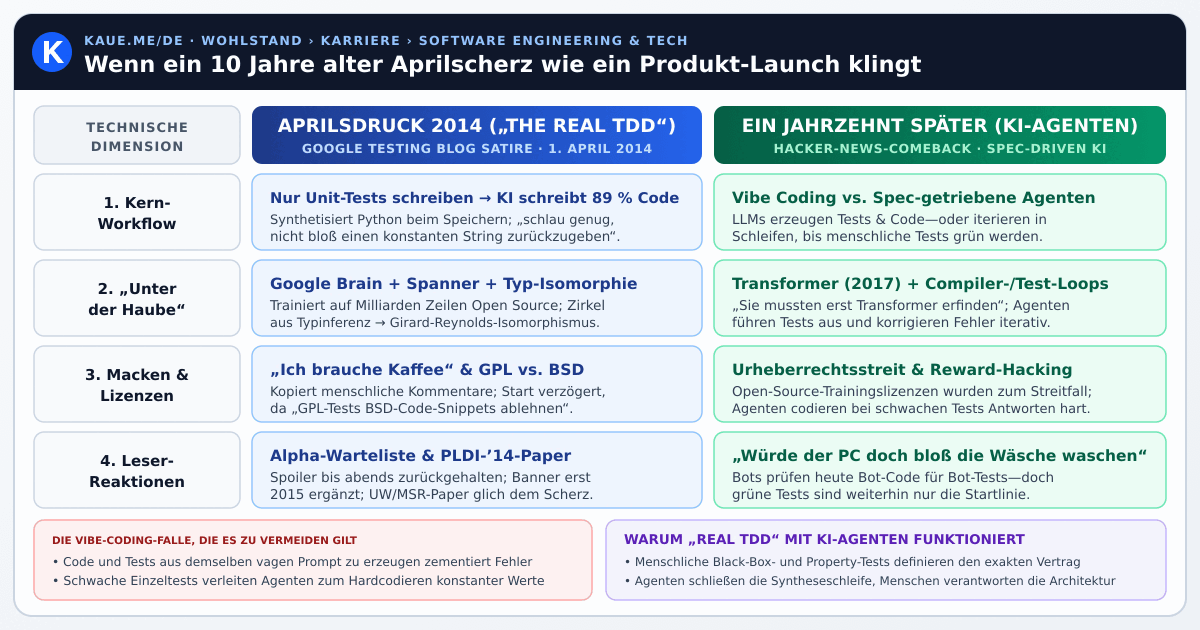
Der Beitrag von 2014 mischte echte Konzepte der Informatik mit den größten Google-Buzzwords jener Ära:
Der lustigste Teil bei der Veröffentlichung dieses Beitrags im Jahr 2014 war nicht das Schreiben der Witze – es war das Lesen der Kommentare in den darauffolgenden Wochen. Am 1. April hielten die Blog-Moderatoren Kommentare, die „April Fools’“ erwähnten, bis zum Abend in der Moderationsschleife zurück, um den Spaß nicht vorzeitig zu verderben, und das rote Banner „Update: APRIL FOOLS!“ ganz oben wurde erst ein volles Jahr später, im April 2015, hinzugefügt. Neben Lesern, die offensichtlich mitspielten, tauchten bis Ende Mai immer wieder Kommentatoren auf, die erst Wochen später über den Artikel gestolpert waren und ernsthaft um einen Platz auf der Alpha-Warteliste baten. Unterdessen meldete sich ein anonymer Kommentator zu Wort und merkte an, dass „die Fiktion das wahre Leben nachahmt“, wobei er auf ein echtes akademisches PLDI-‘14-Paper über testgetriebene Synthese verlinkte, das er gerade gemeinsam mit Koautoren der University of Washington und von Microsoft Research veröffentlicht hatte.
Als der Beitrag Jahre später auf Hacker News wieder auftauchte, fühlte sich das an wie das Öffnen einer Zeitkapsel. Die Reaktionen fielen in mehrere köstliche Kategorien:
Mehrere Kommentatoren wiesen darauf hin, wie unheimlich es war, eine Beschreibung aus dem Jahr 2014 über das Training eines riesigen neuronalen Netzes mit Milliarden Zeilen Open-Source-Code zu lesen, das beim Speichern Funktionen synthetisiert.
Ein Nutzer scherzte:
„Sie kannten 2014 schon die Zukunft und haben irgendwie 10 Jahre verschwendet.“
Worauf ein anderer mit dem ultimativen Konter antwortete:
„Sie mussten zuerst die Transformer erfinden.“
Man vergisst leicht, wie anders die KI-Landschaft im April 2014 noch aussah. Google hatte DeepMind erst zwei Monate zuvor übernommen, und das wegweisende Paper Attention Is All You Need, das die Transformer-Architektur vorstellte, sollte erst 2017 erscheinen. Damals sollte der Satz „Wir haben Google Brain mit dem gesamten Open-Source-Code trainiert, um Python-Code zu schreiben“ so klingen, als würde man einen Teilchenbeschleuniger benutzen, um Brot zu toasten.
Der beiläufige Witz darüber, den Start zu verschieben, bis wir die rechtlichen Fragen beim Mischen von Open-Source-Lizenzen geklärt hätten, ist auf die lustigste (und zugleich düsterste) Weise gealtert. Wie ein HN-Kommentator nach dem Zitieren dieses Absatzes trocken bemerkte:
„Nun, sieht so aus, als hätten sie das inzwischen geklärt!“
Im Jahr 2014 war die Vorstellung, dass ein KI-Modell Code-Snippets über inkompatible Open-Source-Lizenzen hinweg wieder ausspucken könnte, eine Pointe. Ein Jahrzehnt später wurde sie zu einem der prägenden rechtlichen und ethischen Schlachtfelder der generativen KI.
Die vielleicht größte Wendung, die im HN-Thread eingefangen wurde, besteht darin, dass die Satire von 2014 tatsächlich unterschätzt hat, wie faul – oder ehrgeizig – wir werden würden.
Im damaligen Scherz mussten Menschen immerhin noch sorgfältig Unit-Tests mit klaren Assertions schreiben. Wie mehrere Kommentatoren anmerkten, haben wir diesen Schritt komplett übersprungen:
„Wenn die damals gewusst hätten, dass man 10 Jahre später nicht einmal mehr Tests schreiben muss. Muss sich wie eine Sci-Fi-Zeitlinie anfühlen, wenn man einen dieser Blog-Autoren in unsere Zukunft beamen würde.“
„Darüber sind wir längst hinaus, heute können wir sowohl die Tests als auch die Implementierung per Vibe-Coding erzeugen.“
Was unweigerlich zur klassischen existenziellen Klage des modernen Entwicklers führte:
„Mann. Ich wünschte, der Computer würde die Wäsche waschen und mich programmieren lassen. Was ist hier nur schiefgelaufen?“
Unter der Oberfläche der Witze im HN-Thread entwickelte sich eine ernsthafte technische Diskussion – eine, die den Kern dessen trifft, wohin sich die KI-gestützte Softwareentwicklung tatsächlich bewegt.
Als LLMs zum ersten Mal gut im Programmieren wurden, war der gängigste Workflow das genaue Gegenteil von „Real TDD“. Entwickler schrieben die Implementierung (oder ließen sie von einem LLM über eine vage natürlichsprachliche Beschreibung per „Vibe Coding“ erstellen) und baten die KI anschließend, im Nachhinein Unit-Tests zu generieren, nur um Coverage-Metriken zu erfüllen.
Jeder, der schon einmal im Bereich Software-Testing gearbeitet hat, kennt diese Falle: Wenn dasselbe probabilistische Modell ohne fundierte Spezifikation sowohl Ihre Implementierung als auch Ihre Tests generiert, testen Sie kein Verhalten – Sie zementieren lediglich die Halluzinationen des Modells an zwei Stellen gleichzeitig.
Während wir uns jedoch von einfacher Chat-Autovervollständigung hin zu agentenbasierten Coding-Workflows bewegen, verwandelt sich die Prämisse jenes Streichs von 2014 in ein wirklich mächtiges Entwurfsmuster:
Natürlich war das Schreiben guter Tests noch nie der „einfache“ Teil des Software Engineerings. Zu wissen, welche Randfälle wichtig sind, saubere Schnittstellen zu entwerfen und brüchige Mocks zu vermeiden, erfordert genauso viel tiefes Nachdenken wie das Schreiben der Implementierung selbst. Jeder, der schon einmal beobachtet hat, wie ein moderner Coding-Agent eine schwache Test-Suite durch „Reward-Hacking“ austrickst, indem er einfach die exakten Testeingaben hartcodiert, weiß, dass unser Witz von 2014 darüber, „nicht die offensichtliche Implementierung einer konstanten Zeichenkette zu generieren“, ein reales Fehlermuster beschreibt, gegen das man sich absichern muss. Und selbst wenn alle Unit-Tests ehrlich bestehen, kann eine synthetisierte Black Box immer noch subtile Performance-Klippen, Sicherheitslücken oder architektonische Sackgassen verbergen. Klar, inzwischen übernehmen KI-Agenten auch schon die Code-Reviews – Bots prüfen also den Code, den Bots geschrieben haben, um die Tests zu bestehen, die Bots generiert haben –, aber eine grüne Test-Suite ist nach wie vor nur die Startlinie und kein Ersatz dafür, das System wirklich zu verstehen.
Als dieser Beitrag am 1. April 2014 online ging, klang die Vorstellung, dass ein neuronales Netz Ihre Unit-Tests liest, beim Speichern die Implementierung synthetisiert und gelegentlich einen Kommentar mit den Worten „Ich brauche einen Kaffee“ hinterlässt, wie der absolute Gipfel der Comedy.
Wenn heute ein KI-Coding-Assistent den Kommentar „Ich brauche einen Kaffee“ in meinem Pull Request hinterlassen würde, würde ich nicht einmal mit der Wimper zucken – ich würde einfach annehmen, dass er gerade einen Senior Engineer imitiert, bevor ich ihn bitte, meinen Branch zu rebasen. Tatsächlich läuft in einer wunderbaren Ironie des Schicksals inzwischen alles – vom Lektorat dieses Beitrags bis hin zur Übersetzung und Vertonung dieser Website in zehn Sprachen – über KI-Agenten, gesteuert von einem Menschen, der immer noch die Spezifikationen definiert und überprüft.
An alle, die 2014 auf den Beitrag hereingefallen sind und um eine Alpha-Einladung gebeten haben: Entschuldigung für die zehn Jahre Wartezeit – ich hoffe, euch gefällt das Release.
Erhalte eine Benachrichtigung, wenn ich neue Essays, Buchzusammenfassungen und praktische Leitfäden für ein gutes Leben veröffentliche. Kein Spam – jederzeit abbestellbar.
Lade die kuratierte Offline-Ausgabe von Kaues Lebensweise herunter – ein praktischer Leitfaden zur Optimierung von 🍏 Gesundheit, 💰 Wohlstand, ❤️ Liebe und 🧘 Sinn.
Hast du eine Frage, eine Perspektive oder einen Vorschlag? Teile deine Gedanken unten mit. Die Kommentare werden über GitHub Discussions bereitgestellt (werbefrei und spamfrei) – klicke unten auf Mit GitHub anmelden, um zu kommentieren oder zu reagieren (ein kostenloses GitHub-Konto ist in weniger als einer Minute erstellt).
Aktualisiert am 03.11.2026.
HAFTUNGSAUSSCHLUSS: Die Inhalte auf dieser Website dienen ausschließlich Informations- und Bildungszwecken und stellen keine medizinische, psychologische, finanzielle, steuerliche oder rechtliche Beratung sowie keine Anlageberatung dar. Die hier präsentierten Ideen, Zusammenstellungen und Meinungen sind meine eigenen und spiegeln nicht die meines Arbeitgebers wider. Zusammenfassungen von Büchern, Vorträgen und Artikeln sind unabhängige Bildungskommentare und bleiben geistiges Eigentum der jeweiligen Autoren. KI-Tools können zur Unterstützung bei der Bearbeitung, Formatierung und Synthese eingesetzt werden; obwohl größte Sorgfalt auf Richtigkeit gelegt wird, können Fehler auftreten. DATENSCHUTZ: Diese Website nutzt Dienste von Drittanbietern für optionale Newsletter-Abonnements (follow.it), Kommentare (giscus / GitHub Discussions) und eingebettete Medien (YouTube), die IP-Adressen und Cookies der Besucher gemäß ihren jeweiligen Datenschutzrichtlinien verarbeiten können.