Wenn Sie schon einmal versucht haben, auf dem Weg zur Arbeit mit einer App Spanisch oder Französisch zu lernen, ist Ihnen wahrscheinlich einiges wohltuend vertraut vorgekommen. Wörter wie familia oder information ähneln dem Deutschen oder Englischen, Sätze folgen meist einer bekannten Reihenfolge, und das Alphabet ist exakt dasselbe, mit dem Sie aufgewachsen sind.
Stellen Sie sich nun vor, Sie schlagen ein Lehrbuch auf, in dem die Schrift von rechts nach links läuft und die meisten Vokale weglässt – oder in dem ein einziges Verb zwölf völlig verschiedene Formen annimmt, je nachdem, ob Sie jemandem ein Blatt Papier, einen Stock oder einen Welpen reichen.
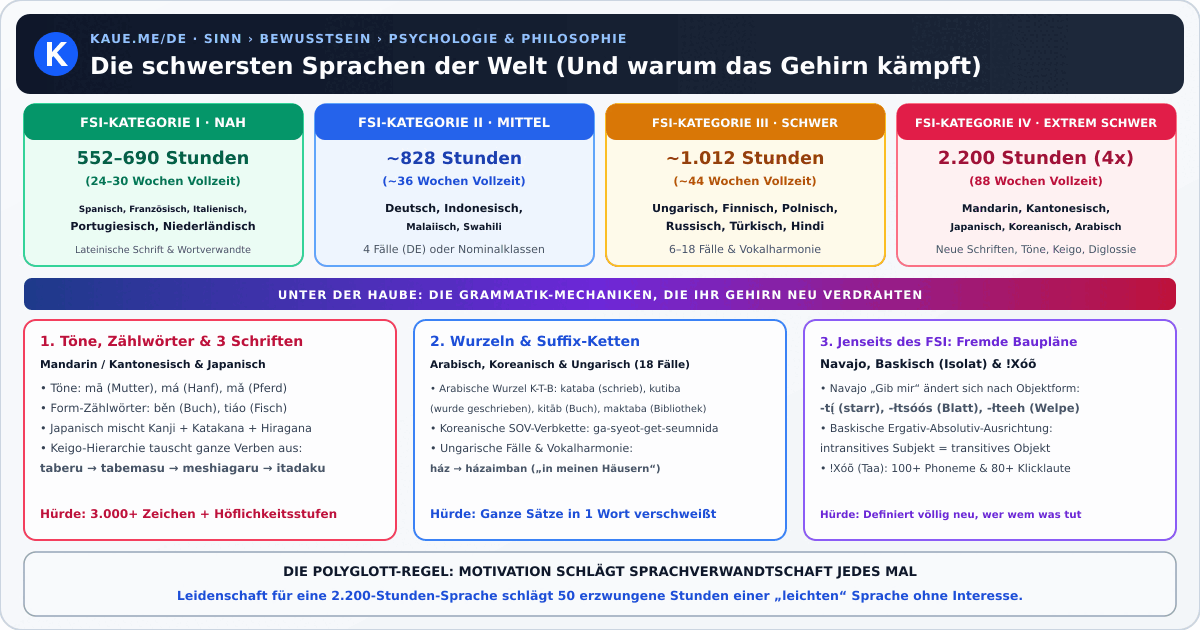
Für englisch- oder deutschsprachige Lernende sind die fünf schwersten großen Weltsprachen Mandarin-Chinesisch, Kantonesisch, Arabisch, Japanisch und Koreanisch. Laut dem Foreign Service Institute (FSI) der US-Regierung – der Ausbildungsstätte für amerikanische Diplomaten – erfordern diese Sprachen der „Kategorie IV“ (extrem schwer) rund 88 Wochen (2.200 Unterrichtsstunden) intensiven Studiums, um berufliche Verhandlungssicherheit zu erreichen. Das ist fast viermal so lang wie bei romanischen oder germanischen Sprachen wie Spanisch, Italienisch oder Niederländisch, für die 552 bis 690 Unterrichtsstunden veranschlagt werden.
Aus rein entwicklungspsychologischer Sicht ist keine Sprache objektiv schwerer als eine andere; Kleinkinder in Tokio, Budapest und Kairo meistern ihre Muttersprache alle in etwa demselben Tempo. Für erwachsene Lernende hängt die Schwierigkeit jedoch von der linguistischen Distanz ab: wie drastisch eine Zielsprache in Schrift, Lautsystem, Wortschatz, kulturellem Kontext und – vor allem – in der Grammatik von der eigenen Muttersprache abweicht (ähnlich wie bei den tiefgreifenden historischen Verschiebungen, die wir in Wie Sokrates’ Daimon zum Dämon des Christentums wurde und Von der Mathematik zu Memes: Die überraschenden Ursprünge von „-Maxxing“ untersucht haben).
Schauen wir uns die härtesten Sprachen der Welt genauer an und blicken wir unter die Haube auf die grammatikalischen Mechanismen, die sie zu einer solchen Herausforderung machen.
Jede der FSI-Spitzensprachen stellt unser Gehirn vor ganz eigene kognitive Hürden.
Auf den ersten Blick wirkt die chinesische Grammatik überraschend gnädig: Es gibt keine Verbkonjugationen, keine grammatischen Geschlechter, keine Pluralendungen bei Substantiven und keine Zeitformen im europäischen Sinne. Stattdessen liegt die Schwierigkeit in der tonalen Phonologie, dem logographischen Schriftsystem sowie dem subtilen Zusammenspiel von Aspektpartikeln und Zählwörtern (Klassifikatoren).
Mandarin verwendet 4 Haupttöne (plus einen neutralen Ton), während Kantonesisch je nach Klassifikation 6 bis 9 Töne nutzt. Eine winzige Veränderung der Tonhöhe verändert die Bedeutung einer Silbe komplett. Darüber hinaus erfordert das Lesen einer Zeitung das Auswendiglernen von 3.000 bis 4.000 verschiedenen Schriftzeichen (Hanzi), die kaum phonetische Hinweise auf ihre Aussprache liefern.
Grammatik-Spotlight: Töne, Zählwörter und Aspekt
Erstens verändert die Tonhöhe im Mandarin die Wortbedeutung vollständig:
- mā (妈 – Hoher, gleichbleibender Ton): Mutter
- má (麻 – Steigender Ton): Hanf / Taub
- mǎ (馬 – Fallend-steigender Ton): Pferd
- mà (骂 – Fallender Ton): Schimpfen
Zweitens kann man Substantive im Chinesischen nicht einfach direkt zählen (z. B. „ein Buch“ oder „drei Hunde“). Jedes Substantiv benötigt zwischen Zahl und Nomen ein spezifisches Zählwort (Klassifikator), das sich nach der Form oder Beschaffenheit des Objekts richtet:
- yī běn shū (一本书): Ein [Klassifikator für gebundene Bände] Buch
- yī tiáo yú (一条鱼): Ein [Klassifikator für lange, biegsame Dinge] Fisch
- yī zhāng zhuōzi (一张桌子): Ein [Klassifikator für flache Oberflächen] Tisch
Da Verben niemals nach Zeiten konjugiert werden, tragen schließlich der Kontext und Aspektpartikeln wie le (了) oder guo (过) die zeitliche Information:
- Wǒ chī fàn (我吃饭): Ich esse Reis / Ich esse gerade. (Wörtlich: „Ich essen Mahlzeit.“)
- Wǒ chī le fàn (我吃了饭): Ich habe die Mahlzeit gegessen. (Die Partikel le markiert eine abgeschlossene Handlung, nicht die Vergangenheit selbst – sie kann sogar für die Zukunft stehen im Sinne von „Sobald ich gegessen habe …“)
Vom FSI oft als die zeitaufwendigste Sprache selbst innerhalb der Kategorie IV genannt, verlangt Japanisch das gleichzeitige Jonglieren mit drei verschiedenen Schriftsystemen innerhalb eines einzigen Satzes:
Abgesehen vom Lesen folgen japanische Sätze der Wortstellung Subjekt-Objekt-Verb (SOV), nutzen nachgestellte Partikeln und erzwingen ein hochkomplexes System aus Höflichkeitsstufen und Honorifics (Keigo), bei dem sich Verben und Wortschatz je nach sozialer Hierarchie drastisch verändern.
Grammatik-Spotlight: Drei Schriften + Soziale Hierarchie (Keigo)
Sehen Sie sich an, wie alle drei Schriftsysteme in einem einzigen schlichten Satz auftauchen: „Ich habe in einem Café Kaffee getrunken.“
- 私はカフェでコーヒーを飲みました。 (Watashi wa kafe de kōhī o nomimashita.)
- 私 (Watashi – „Ich“) und 飲 (no- – Wortstamm von „trinken“) werden in Kanji geschrieben.
- カフェ (kafe – „Café“) und コーヒー (kōhī – „Kaffee“) sind Fremdwörter in Katakana.
- は (wa – Themenpartikel), で (de – Ortspartikel „in“), を (o – Akkusativpartikel) und みました (mimashita – höfliche Vergangenheitsendung) stehen in Hiragana.
Und nun betrachten Sie, was mit einem einfachen Verb wie „essen / trinken“ (taberu / nomu) geschieht, je nachdem, mit wem Sie sprechen:
- Informell (unter engen Freunden): Taberu (食べる)
- Höflich (alltäglicher Standard): Tabemasu (食べます)
- Respektvoll / Ehrerbietig (Sonkeigo – erhöht das Handeln eines Chefs oder Kunden): Meshiagaru (召し上がる)
- Bescheiden (Kenjōgo – stellt das eigene Handeln gegenüber Höhergestellten zurück): Itadaku (いただく)
Das Verb erhält nicht bloß eine höfliche Endung – es verwandelt sich in ein komplett anderes Wort!
Arabisch wird von rechts nach links in einer Abdschad-Konsonanterschrift geschrieben, bei der Buchstaben ihre Form ändern, je nachdem, ob sie am Anfang, in der Mitte oder am Ende eines Wortes stehen, und kurze Vokale in alltäglichen Büchern und Zeitungen weggelassen werden. Oft muss man das Wort und seine grammatische Rolle im Satz bereits kennen, nur um zu wissen, wie man es laut ausspricht.
Die größte praktische Hürde ist jedoch die Diglossie: Das Moderne Hocharabisch (MSA, verwendet in Nachrichten, Literatur und formellen Reden) unterscheidet sich drastisch von den gesprochenen regionalen Dialekten (wie Ägyptisch-, Levantinisch- oder Marokkanisch-Arabisch). Lernende müssen praktisch zwei Versionen der Sprache gleichzeitig studieren.
Grammatik-Spotlight: Das System der dreiradikaligen Wurzeln
Anders als indogermanische Sprachen, die Wörter durch Vor- und Nachsilben an einem festen Stamm bilden (wie Tat → tätig → Betätigung), nutzt das Arabische eine nicht-verkettende Morphologie. Die meisten Wörter basieren auf einem Gerüst aus drei Konsonanten, das eine Grundbedeutung trägt. Indem man verschiedene Vokalmuster und Zusatzkonsonanten in und um dieses Gerüst webt, entsteht eine ganze Wortfamilie.
Nehmen wir die Wurzel K – T – B (ك - ت - ب), die das Grundkonzept „Schreiben“ trägt:
- KaTaBa (kataba): Er schrieb (aktives Verb der Vergangenheit)
- KuTiBa (kutiba): Es wurde geschrieben (passives Verb der Vergangenheit – allein durch interne Vokale verändert!)
- KiTāB (kitāb): Buch
- KuTuB (kutub): Bücher (ein „gebrochener Plural“, gebildet durch Vokalwechsel im Wortinneren statt durch eine Endung)
- KāTiB (kātib): Schriftsteller / Autor
- maKTaB (maktab): Schreibtisch / Büro (das Präfix ma- bezeichnet einen Ort der Handlung)
- maKTaBa (maktaba): Bibliothek / Buchhandlung
Ironischerweise verfügt Koreanisch über das unter Sprachwissenschaftlern als wohl einfachstes und logischstes geltende Schriftsystem der Welt: Hangul, ein 1443 von König Sejong in Auftrag gegebenes phonetisches Alphabet, das man an einem einzigen Nachmittag lernen kann.
Die Falle schnappt unmittelbar nach dem Erlernen des Alphabets zu. Wie das Japanische verwendet auch das Koreanische die Satzstellung Subjekt-Objekt-Verb (SOV), was bedeutet, dass das Verb immer ganz am Ende des Satzes steht – man weiß also erst, ob jemand etwas kauft, hasst oder isst, wenn der Sprecher seinen Satz beendet hat. Zudem ist Koreanisch stark agglutinierend und schweißt ganze Ketten von Suffixen an Verbstämme, um Zeitform, Modus, Kausalität und sieben verschiedene Höflichkeitsstufen auszudrücken.
Grammatik-Spotlight: Agglutinierende Verbketten & Höflichkeitsstufen
Im Deutschen nutzen wir Hilfswörter („ist wohl gegangen“), um ein Verb zu modifizieren. Im Koreanischen werden diese Konzepte direkt an den Verbstamm 가- (ga-, „gehen“) geschweißt:
- 가다 (ga-da): Gehen (Wörterbuchform)
- 가시었다 → 가셨다 (ga-si-eot-da): Ging (Subjekt-Honorific -si- für eine respektierte Person + Vergangenheit -eot-)
- 가셨겠습니다 (ga-syeot-get-seumnida): „[Eine respektierte Person] ist wohl gegangen.“
- 가- (ga-): Wortwurzel („gehen“)
- -시- (-si-): Subjekt-Honorific (ehrt die gehende Person)
- -었- (-eot-): Vergangenheitsmarker
- -겠- (-get-): Vermutungs- / Annahmemarker („wohl / vermutlich“)
- -습니다 (-seumnida): formell-höfliche Endung gegenüber dem Zuhörer
Man muss das lateinische Alphabet nicht verlassen, um gegen eine sprachliche Wand zu prallen. Sprachen der Kategorie III erfordern rund 44 Wochen (1.012 Unterrichtsstunden) intensiven Studiums und sind berüchtigt für ihre labyrinthischen Beugungsformen.
Fast alle europäischen Sprachen – von Spanisch und Englisch bis Russisch und Griechisch – gehören zur indogermanischen Sprachfamilie. Ungarisch, Finnisch und Estnisch gehören nicht dazu. Sie entstammen der uralischen Sprachfamilie, teilen praktisch keinen Grundwortschatz mit dem Deutschen oder Englischen und folgen einem völlig anderen grammatischen Bauplan: starke Agglutination, Vokalharmonie und 14 bis 18 grammatische Fälle (Kasus).
Anstatt Präpositionen wie in, auf, zu, aus oder mit vor ein Substantiv zu stellen, hängen uralische Sprachen ganze Kaskaden von Suffixen an das Wortende. Wegen der Vokalharmonie existiert zudem jedes Suffix in mehreren Varianten (vordere vs. hintere Vokale), damit alle Vokale eines Wortes klanglich harmonieren.
Grammatik-Spotlight: Ungarische Kasus-Stapelung & Vokalharmonie
Beobachten Sie, wie das ungarische Substantiv ház (Haus) in sich aufnimmt, wofür wir im Deutschen eine ganze Wortgruppe brauchen:
- ház: Haus
- házak: Häuser (Plural -ak)
- házaim: meine Häuser (Possessivplural -aim)
- házaimban: in meinen Häusern (Inessiv-Suffix -ban für „in“)
- házaimból: aus meinen Häusern heraus (Elativ-Suffix -ból für „aus … heraus“)
Da ház einen dunklen (hinteren) Vokal (á) enthält, erhält es das hintere Suffix -ban („in“). Verwendet man hingegen das Wort kert (Garten) mit einem hellen (vorderen) Vokal (e), erzwingt die Vokalharmonie die Suffixform -ben: kertemben (in meinem Garten).
Slawische Sprachen wie Russisch (6 Fälle) und Polnisch (7 Fälle) zwingen Lernende dazu, die exakte grammatische Funktion jedes einzelnen Wortes im Satz im Kopf zu behalten. Im Englischen verrät meist die Wortstellung, wer was getan hat: „The dog bit the man“ bedeutet das Gegenteil von „The man bit the dog.“
Im Polnischen und Russischen verraten die Wortendungen, wer wem was getan hat. Dadurch kann die Wortstellung zur Betonung fast beliebig umgestellt werden, während jedes Substantiv, Adjektiv, Pronomen und sogar Zahlwort seine Endung ändert. Obendrein treten slawische Verben in Aspektpaaren auf (unvollendet vs. vollendet), sodass man für fast jede Tätigkeit zwei verschiedene Verben lernen muss, je nachdem, ob die Handlung andauert oder einmalig abgeschlossen wird.
Grammatik-Spotlight: „Die schwarze Katze“ durch die 7 Fälle des Polnischen
Sehen Sie sich an, wie sich „schwarze Katze“ (czarny kot) durch die 7 polnischen Fälle verändert:
- Nominativ (Subjekt): Czarny kot śpi. (Die schwarze Katze schläft.)
- Genitiv (Besitz / Verneinung): Nie widzę czarnego kota. (Ich sehe die schwarze Katze nicht.)
- Dativ (Indirektes Objekt): Daję mleko czarnemu kotu. (Ich gebe der schwarzen Katze Milch.)
- Akkusativ (Direktes Objekt): Widzę czarnego kota. (Ich sehe die schwarze Katze.)
- Instrumental („Mit / Mittels“): Idę z czarnym kotem. (Ich gehe mit der schwarzen Katze.)
- Lokativ (Ort): Mówię o czarnym kocie. (Ich spreche über die schwarze Katze.)
- Vokativ (Anrede): O, czarny kocie! (Oh, schwarze Katze!)
Beachten Sie, wie im Lokativ und Vokativ sogar der letzte Konsonant des Wortstamms von -t zu -ci- mutiert (kot → kocie)!
Durch seine geografische Isolation im Nordatlantik hat sich das Isländische seit der Ankunft nordischer Siedler im 9. Jahrhundert kaum verändert. Heutige Isländer können mittelalterliche Wikingersagas noch immer relativ mühelos lesen. Für Lernende bedeutet das jedoch, die archaische altnordische Grammatik zu meistern: vier Fälle, drei Geschlechter, hochgradig unregelmäßige Verbkonjugationen, die Zahlen von 1 bis 4, die nach Geschlecht und Fall dekliniert werden, sowie einen konsequenten Sprachpurismus, der internationale Fremdwörter zugunsten altnordischer Neuschöpfungen ablehnt (so heißt „Computer“ auf Isländisch tölva, verschmolzen aus den Wörtern für „Zahl“ und „Seherin“).
Das FSI bewertet nur Sprachen, die regelmäßig für Diplomaten unterrichtet werden. Außerhalb diplomatischer Lehrpläne führen etliche Sprachen der Welt die menschliche Grammatik in Gefilde, die auf indogermanische Sprecher wie von einem anderen Stern wirken.
Im Zweiten Weltkrieg vom US Marine Corps berühmt als unknackbarer Code eingesetzt, ist Navajo eine im amerikanischen Südwesten gesprochene polysynthetische, verbzentrierte Sprache. Ein einziges Navajo-Verb kann so viele Informationen bündeln wie ein ganzer deutscher Satz, indem es Subjektpronomen, Objektpronomen, Modus, Aspekt und Richtungspräfixe zu einem dichten morphologischen Puzzle verwebt.
Vor allem aber nutzt Navajo klassifikatorische Verbstämme: Es gibt kein einzelnes allgemeines Verb für „geben“, „fallen lassen“ oder „tragen“. Stattdessen muss man aus einem Dutzend völlig verschiedener Verbstämme wählen – je nach physischer Form, Beschaffenheit und Belebtheit des jeweiligen Gegenstands.
Grammatik-Spotlight: Klassifikatorische Verben im Navajo („Gib mir …“)
Wenn Sie auf Navajo „Gib es mir“ sagen möchten, ändert sich der Verbstamm am Wortende komplett danach, wie das Objekt beschaffen ist:
- Langes, starres Objekt (Stift, Stock oder Gewehr): Shaa nítį́ (Stamm: -tį́)
- Flaches, biegsames Objekt (Blatt Papier, Decke oder Geldschein): Shaa níłtsóós (Stamm: -łtsóós)
- Einzelnes rundes oder kompaktes Objekt (Ball, Buch oder Apfel): Shaa ní*’ą́*** (Stamm: -’ą́)
- Breiige oder formlose Masse (Schlamm oder feuchter Teig): Shaa nítleeh (Stamm: -tleeh)
- Lebewesen (Welpe oder Baby): Shaa níłteeh (Stamm: -łteeh)
In den Pyrenäen zwischen Nordspanien und Südwestfrankreich gesprochen, ist Baskisch eine isolierte Sprache – ein vorindogermanischer Überlebender, der mit keiner anderen bekannten lebenden Sprache der Erde verwandt ist.
Neben seinem völlig eigenständigen Wortschatz verwendet das Baskische eine ergativ-absolutive grammatische Ausrichtung. Im Deutschen, Englischen und fast allen europäischen Sprachen wird das Subjekt eines Satzes immer gleich behandelt (Nominativ), unabhängig davon, ob das Verb ein direktes Objekt hat oder nicht:
Das Baskische verdrahtet diese Logik komplett neu. Im Baskischen wird das Subjekt eines intransitiven Verbs („Der Mann kam an“) exakt genauso markiert wie das direkte Objekt eines transitiven Verbs („Der Junge sah den Mann“), während die Person, die eine transitive Handlung ausführt, eine spezielle Ergativ-Endung (-k) erhält.
Grammatik-Spotlight: Ergativ-Absolutiv-Ausrichtung im Baskischen
Sehen Sie, was mit den baskischen Wörtern gizon (Mann) und mutil (Junge) passiert:
- Intransitiver Satz: Gizona etorri da. („Der Mann ist angekommen.“)
- Hier steht gizon-a im Absolutiv (Grundwort + -a „der“).
- Transitiver Satz: Mutilak gizona ikusi du. („Der Junge hat den Mann gesehen.“)
- Hier ist „der Mann“ (gizon-a) nun das direkte Objekt, behält aber exakt dieselbe Absolutivform (gizona) wie bei seiner Ankunft!
- „Der Junge“ (mutila) hingegen muss, weil er eine Handlung an jemand anderem vollzieht, das Ergativ-Suffix -k annehmen: mutilak.
Hauptsächlich in Botswana und Namibia gesprochen, hält ǃXóõ den Weltrekord für das größte Phoneminventar aller Sprachen der Erde. Während das Deutsche oder Englische mit rund 40 bis 44 verschiedenen Sprachlauten (Phonemen) auskommt, nutzt ǃXóõ weit über 100 verschiedene Konsonanten und Vokale, darunter mehr als 80 verschiedene Klicklaute (Schnalzlaute) in Kombination mit Nasalierung, Behauchung, Glottalisierung und vier Tönen. Selbst das ausrufezeichenähnliche Symbol am Anfang seines Namens (ǃ) steht für einen alveolaren Klicklaut, bei dem die Zunge vom Gaumen nach unten schnalzt.
| FSI-Kategorie | Vollzeitstudium | Unterrichtsstunden | Typische Sprachen | Größte Hürde |
|---|---|---|---|---|
| Kategorie I (Eng verwandt) | 24–30 Wochen | 552–690 Std. | Spanisch, Französisch, Italienisch, Portugiesisch, Niederländisch, Schwedisch | Einfache Verbkonjugationen und grammatisches Geschlecht |
| Kategorie II (Mittlere Distanz) | ~36 Wochen | 828 Std. | Deutsch, Indonesisch, Malaiisch, Swahili | Kasussysteme (Deutsch) oder fremder Grundwortschatz (Swahili/Indonesisch) |
| Kategorie III (Schwer) | ~44 Wochen | 1.012 Std. | Russisch, Polnisch, Ungarisch, Finnisch, Türkisch, Hindi, Vietnamesisch | Umfangreiche Kasussysteme, Agglutination, Töne oder nicht-lateinische Schriften |
| Kategorie IV (Extrem schwer) | 88 Wochen | 2.200 Std. | Mandarin, Kantonesisch, Japanisch, Koreanisch, Arabisch | Logographische/Abdschad-Schriften, Tonalität, Diglossie und Höflichkeitssysteme |
Wenn man auf 2.200 Lernstunden oder 18 grammatische Fälle blickt, fühlt man sich leicht eingeschüchtert. Doch erfahrene Polyglotte und Sprachwissenschaftler sind sich in einem entscheidenden Punkt einig: Motivation und tägliche Konstanz schlagen sprachliche Verwandtschaft jedes einzelne Mal (besonders in Verbindung mit dem Architekt-vs.-Bauarbeiter-System aus Lassen Sie Ihre Laune nicht über Ihren Zeitplan abstimmen ).
Wer für japanisches Kino, koreanische Musik oder arabische Geschichte brennt, wird gerne 2.000 Stunden Übung investieren und fließend sprechen lernen – während jemand, der sich lustlos zu einer „Kategorie-I-Sprache“ zwingt, nach 50 Stunden aufgibt. Jedes scheinbar „unmögliche“ Grammatikmerkmal – ob chinesische Töne, ungarische Suffixketten oder baskische Ergativität – ist letztlich nur ein weiterer faszinierender Weg, den der menschliche Geist gefunden hat, um die Wirklichkeit zu ordnen.
Erhalte eine Benachrichtigung, wenn ich neue Essays, Buchzusammenfassungen und praktische Leitfäden für ein gutes Leben veröffentliche. Kein Spam – jederzeit abbestellbar.
Lade die kuratierte Offline-Ausgabe von Kaues Lebensweise herunter – ein praktischer Leitfaden zur Optimierung von 🍏 Gesundheit, 💰 Wohlstand, ❤️ Liebe und 🧘 Sinn.
Hast du eine Frage, eine Perspektive oder einen Vorschlag? Teile deine Gedanken unten mit. Die Kommentare werden über GitHub Discussions bereitgestellt (werbefrei und spamfrei) – klicke unten auf Mit GitHub anmelden, um zu kommentieren oder zu reagieren (ein kostenloses GitHub-Konto ist in weniger als einer Minute erstellt).
Aktualisiert am 13.11.2026.
HAFTUNGSAUSSCHLUSS: Die Inhalte auf dieser Website dienen ausschließlich Informations- und Bildungszwecken und stellen keine medizinische, psychologische, finanzielle, steuerliche oder rechtliche Beratung sowie keine Anlageberatung dar. Die hier präsentierten Ideen, Zusammenstellungen und Meinungen sind meine eigenen und spiegeln nicht die meines Arbeitgebers wider. Zusammenfassungen von Büchern, Vorträgen und Artikeln sind unabhängige Bildungskommentare und bleiben geistiges Eigentum der jeweiligen Autoren. KI-Tools können zur Unterstützung bei der Bearbeitung, Formatierung und Synthese eingesetzt werden; obwohl größte Sorgfalt auf Richtigkeit gelegt wird, können Fehler auftreten. DATENSCHUTZ: Diese Website nutzt Dienste von Drittanbietern für optionale Newsletter-Abonnements (Mailchimp), Kommentare (giscus / GitHub Discussions) und eingebettete Medien (YouTube), die IP-Adressen und Cookies der Besucher gemäß ihren jeweiligen Datenschutzrichtlinien verarbeiten können.